लंबे एजेंट रन के लिए बेहतर token दक्षता


जैसे-जैसे एजेंट परिपक्व हुए हैं और उन्होंने अधिक महत्वाकांक्षी कार्य निपटाना सीखा है, token खर्च का स्वरूप भी बदल गया है। एजेंट अब अधिक देर तक काम करते हैं और एक चरण से दूसरे चरण तक अधिक संदर्भ साथ लेकर चलते हैं, जिससे यह और भी महत्वपूर्ण हो जाता है कि हम उस संदर्भ को कैसे जुटाते और प्रबंधित करते हैं।
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
नोट: सिस्टम और टूल परिभाषाओं में कॉम्पैक्शन सारांश शामिल हैं। उपयोगकर्ता टेक्स्ट में मैन्युअल रूप से संलग्न किए गए कौशल शामिल हैं। कौशल और प्लगइन्स में कौशल विवरण, MCP टूल विवरण, और स्थिर संदर्भ में जाने वाले नियम शामिल हैं।
पिछले कुछ महीनों में हमने Cursor के एजेंट हार्नेस की दक्षता बेहतर करके इस बदलाव का जवाब दिया है। एजेंट हार्नेस हमें इस बात पर सीधा नियंत्रण देता है कि हर अनुरोध कैसे तैयार होता है, संदर्भ का दोबारा उपयोग कैसे होता है, और काम को एजेंट के बीच कब बाँटा जाता है। इन सभी परतों में किए गए परिवर्तनों से एजेंट की गुणवत्ता घटाए बिना उपयोगकर्ताओं की token लागत में 7% की कमी आई।
सिस्टम प्रॉम्प्ट को छोटा करना
हर एजेंट टर्न में वह संदर्भ शामिल होता है जो मॉडल के काम शुरू करने से पहले Cursor देता है। इसमें सिस्टम प्रॉम्प्ट और एजेंट जिन उपकरणों का उपयोग कर सकता है, उनकी परिभाषाएँ शामिल होती हैं। चूँकि यह संदर्भ पूरी बातचीत के दौरान बना रहता है, यह खर्च के उन सबसे बड़े स्रोतों में से एक बन गया था जो पूरी तरह हमारे नियंत्रण में हैं।
जब मॉडल कम सक्षम थे, तब हमें टूल के उपयोग, कार्य प्रबंधन और कोड-परिवर्तन वर्कफ़्लो के निर्देश विस्तार से लिखने पड़ते थे। साथ ही, बेहद लंबे हैश डंप, बाइनरी आउटपुट और इमोजी जैसे अजीब व्यवहारों से भी बचाव करना पड़ता था।
जैसे-जैसे मॉडल बेहतर हुए, उनमें से ज़्यादातर दिशा-निर्देश अनावश्यक होते गए। "ऐसा मत करो," "आपको अवश्य" या "महत्वपूर्ण" जैसे निर्देशों की लंबी सूचियों के बजाय, हम बस यह परिभाषित कर सकते थे कि कोई टूल कैसे व्यवहार करता है, और मॉडल आम तौर पर उसका पालन कर लेते थे। यह बात सभी मॉडल परिवारों पर लागू हुई, जिससे हम अपने सिस्टम प्रॉम्प्ट का लगभग 66% हिस्सा कम कर पाए।
समय के साथ हम निर्देश जोड़ते और हटाते रहते हैं, क्योंकि नए मॉडल को नए मार्गदर्शन की ज़रूरत होती है, और वही आगे चलकर भविष्य के मॉडल के प्रशिक्षण में शामिल हो जाता है। वास्तविक ट्रैफ़िक के लिए उपयोग में लाने को प्रभावी ढंग से अनुकूलित करने में बड़े उपयोगकर्ता आधार पर A/B परीक्षण का लाभ उठाना बेहद अहम है। evals एक तेज़ और उपयोगी प्रॉक्सी हो सकते हैं, लेकिन वे अक्सर "कठिन" समस्याएँ दर्शाते हैं और उपयोगकर्ता अनुरोधों के वास्तविक वितरण को ठीक से नहीं दिखाते।
उपकरणों को केवल आवश्यकता पड़ने पर लोड करना
सिस्टम प्रॉम्प्ट उस संदर्भ का केवल एक हिस्सा है जो Cursor हर टर्न पर देता है। दूसरा हिस्सा है उपकरण परिभाषाएँ, जो इस साल के दौरान काफ़ी बढ़ गई थीं, क्योंकि हमने Cursor एजेंट में और अधिक सशक्त क्षमताएँ जोड़ीं — जैसे बैकग्राउंड शेल निगरानी, क्लाउड उप-एजेंट, और वेब Content तक अधिक विश्वसनीय पहुँच। इनमें से अधिकांश उपकरण महत्वपूर्ण हैं, लेकिन प्रत्येक की आवश्यकता 20% से भी कम वार्तालाप में पड़ती है।
इससे दक्षता सुधारने का एक अवसर बना — उपकरणों को उपलब्ध रखते हुए भी उनकी पूरी परिभाषाएँ हर अनुरोध में शामिल न करना। इस साल पहले हमने एक ऐसी ही समस्या हल की थी, जब हमने MCP उपकरणों को डायनेमिक संदर्भ में ले जाकर उन्हें केवल आवश्यकता पड़ने पर लोड करना शुरू किया। इससे MCP उपकरण को कॉल करने वाले सत्रों में कुल token 46.9% घट गए।
अब हमने यही तकनीक अपने बिल्ट-इन उपकरणों पर भी लागू की है।
यह तय करने के लिए कि कौन-से उपकरण स्थिर संदर्भ में रखे जाएँ, हमने कई कॉन्फ़िगरेशन का A/B परीक्षण किया — इस आधार पर कि प्रत्येक उपकरण कितनी बार उपयोग होता है और क्या मॉडल को उसे शुरू से देखने की आवश्यकता होती है। हमने token उपयोग, लागत, लेटेंसी, उपकरण-कॉल errors, और समग्र एजेंट उपयोग को ट्रैक किया, ताकि यह सुनिश्चित हो सके कि इस बचत से गुणवत्ता में गिरावट न आए।
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
अंततः, हमने पठन, खोज, संपादन और शेल के इस्तेमाल वाले उच्च-आवृत्ति उपकरणों को स्थिर संदर्भ में ही रखा। ask_question को भी बनाए रखा, क्योंकि कुछ मॉडल उसके कॉल्स की कल्पना कर लेते थे, और वे उपकरण भी रखे जो विशिष्ट उत्पाद प्रवाहों के लिए अत्यंत महत्वपूर्ण हैं, जैसे योजना मोड में create_plan। शेष उपकरण अब तब लोड होते हैं जब एजेंट को उनकी आवश्यकता होती है।
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
कैश पुन: उपयोग में सुधार
हर अनुरोध में स्थिर संदर्भ की मात्रा घटाने के बाद, हमने यह बेहतर किया कि दोहराए जाने वाले संदर्भ को टर्न-दर-टर्न कितने प्रभावी ढंग से कैश किया जा सके।
हर एजेंट टर्न पर एक लंबा अनुरोध दोबारा भेजा जाता है, जिसमें उपकरण, सिस्टम निर्देश, सेटअप और अब तक की बातचीत शामिल होती है। शुरुआत का अधिकांश हिस्सा एक टर्न से दूसरे टर्न तक वैसा ही रहता है, जबकि अंत में बातचीत लगातार बढ़ती जाती है।
प्रॉम्प्ट कैशिंग की मदद से मॉडल प्रदाता उस अपरिवर्तित उपसर्ग का पुन: उपयोग कर सकता है। हालाँकि, कैशिंग की कॉन्फ़िगरेबिलिटी हर प्रदाता में अलग-अलग हो सकती है। GPT-5.6 से पहले, कैश सीमा नवीनतम अनुरोध के आधार पर स्वचालित रूप से तय होती थी। उपकरण और सिस्टम निर्देश शायद ही कभी बदलते थे, फिर भी उन्हें अलग से पुन: उपयोग योग्य के रूप में स्पष्ट रूप से चिह्नित नहीं किया जाता था।
GPT-5.6 के बाद से, OpenAI API क्लाइंट को अपनी डिफ़ॉल्ट अंतर्निहित कैशिंग के साथ-साथ स्पष्ट कैश ब्रेकपॉइंट चिह्नित करने की अनुमति देता है। अब हम अनुरोध की स्थिर परतों के बाद और बढ़ती बातचीत से पहले ब्रेकपॉइंट रखते हैं, जिससे बाद के टर्न अपरिवर्तित उपसर्ग का अधिक हिस्सा पुन: उपयोग कर पाते हैं।
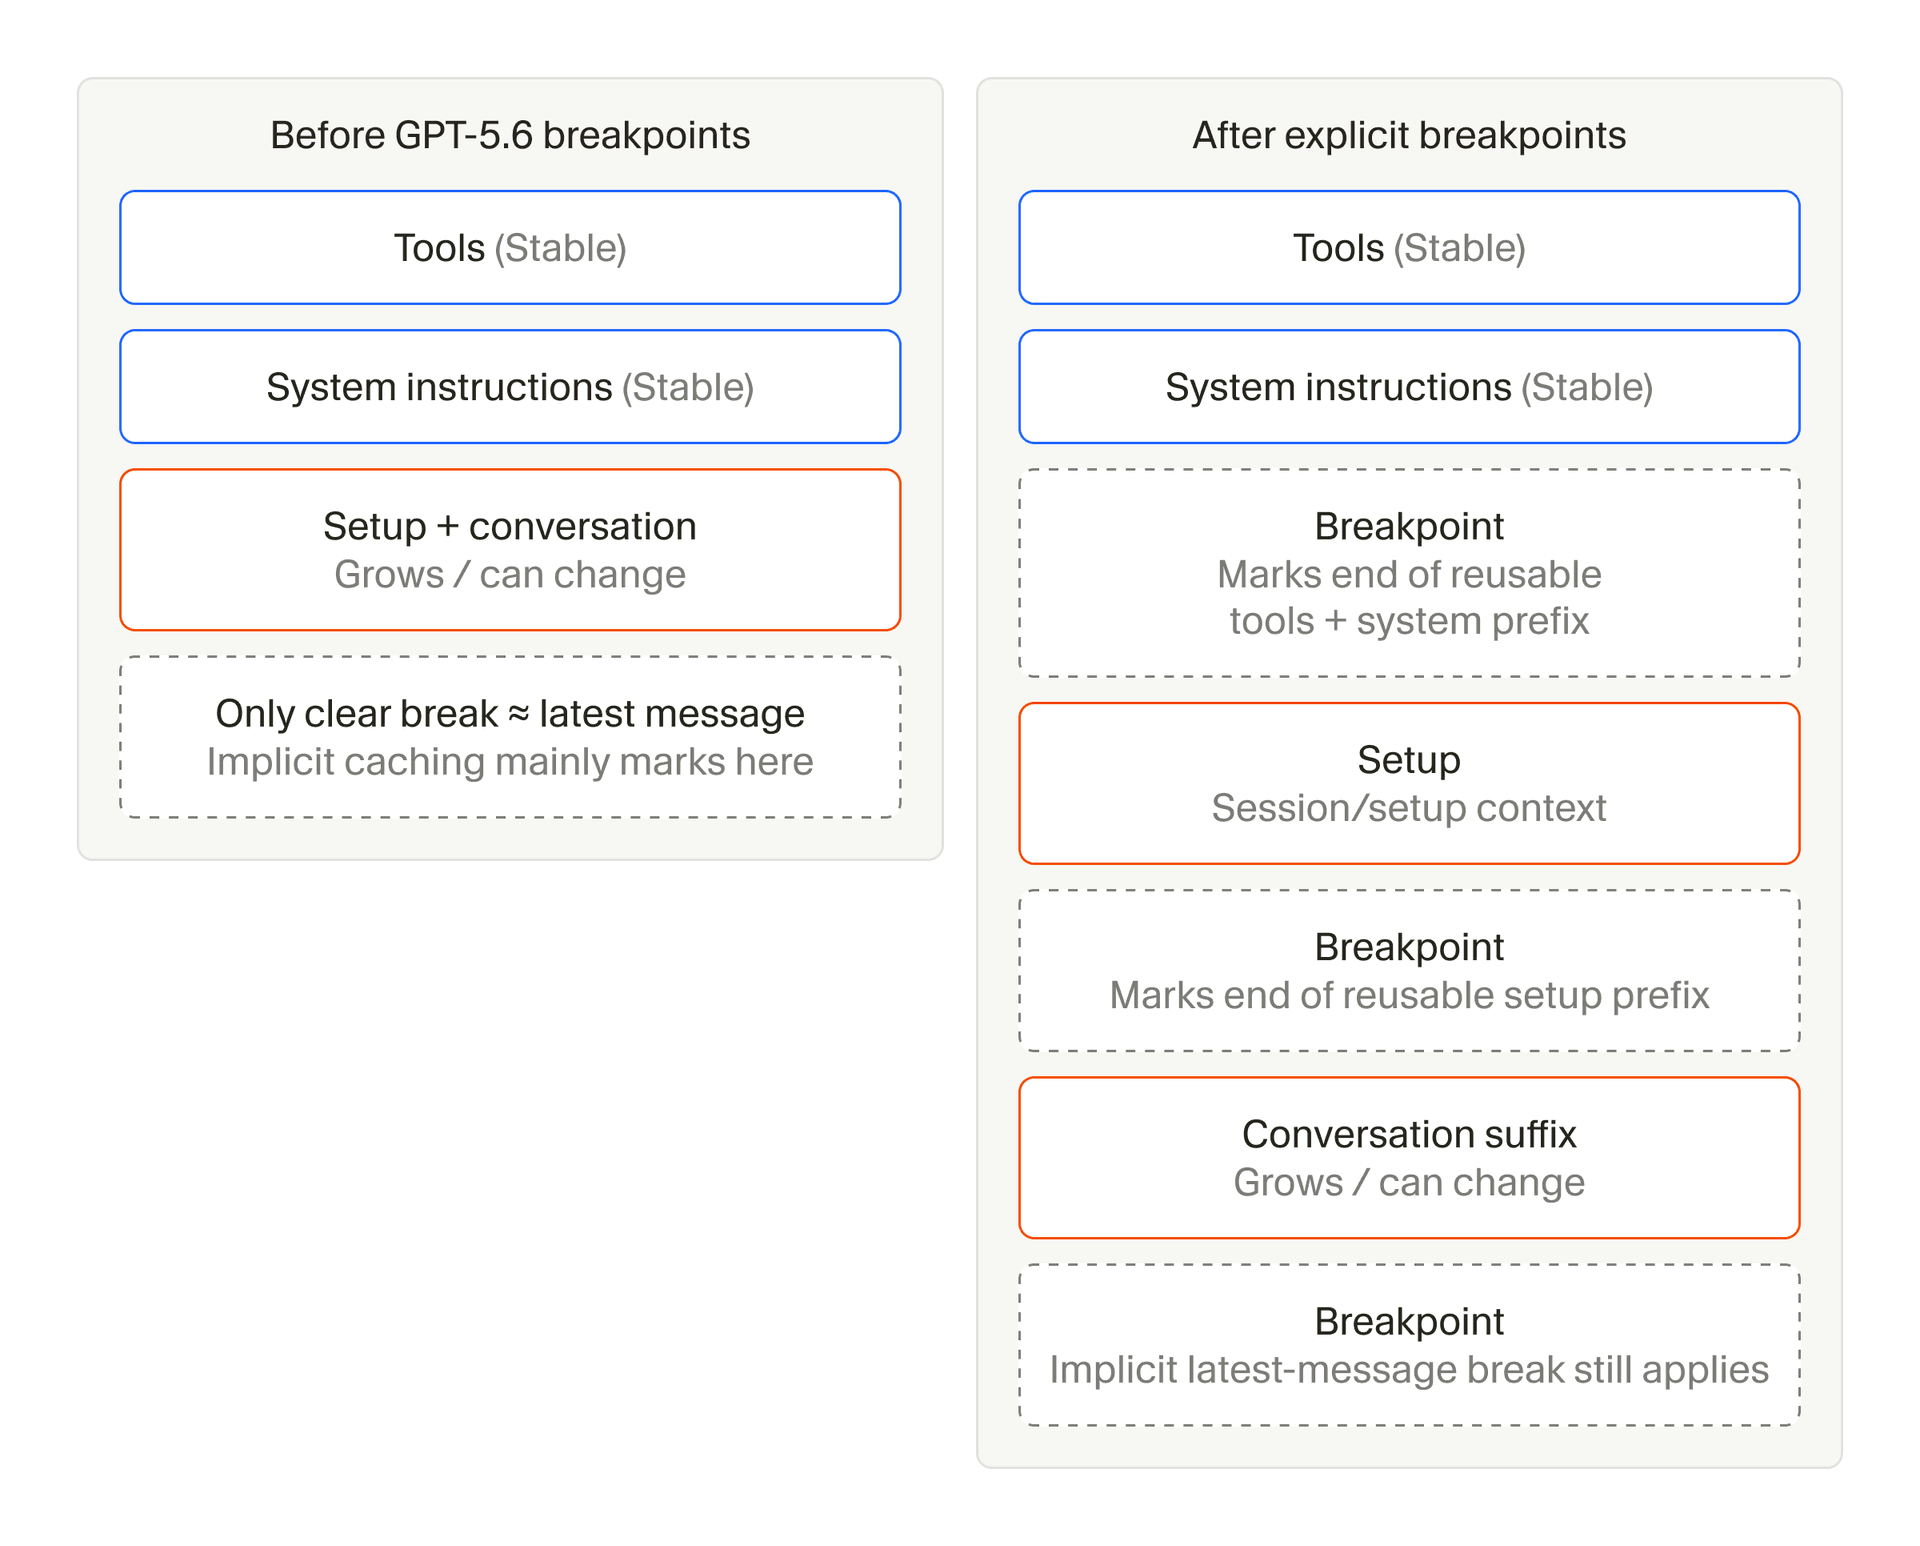
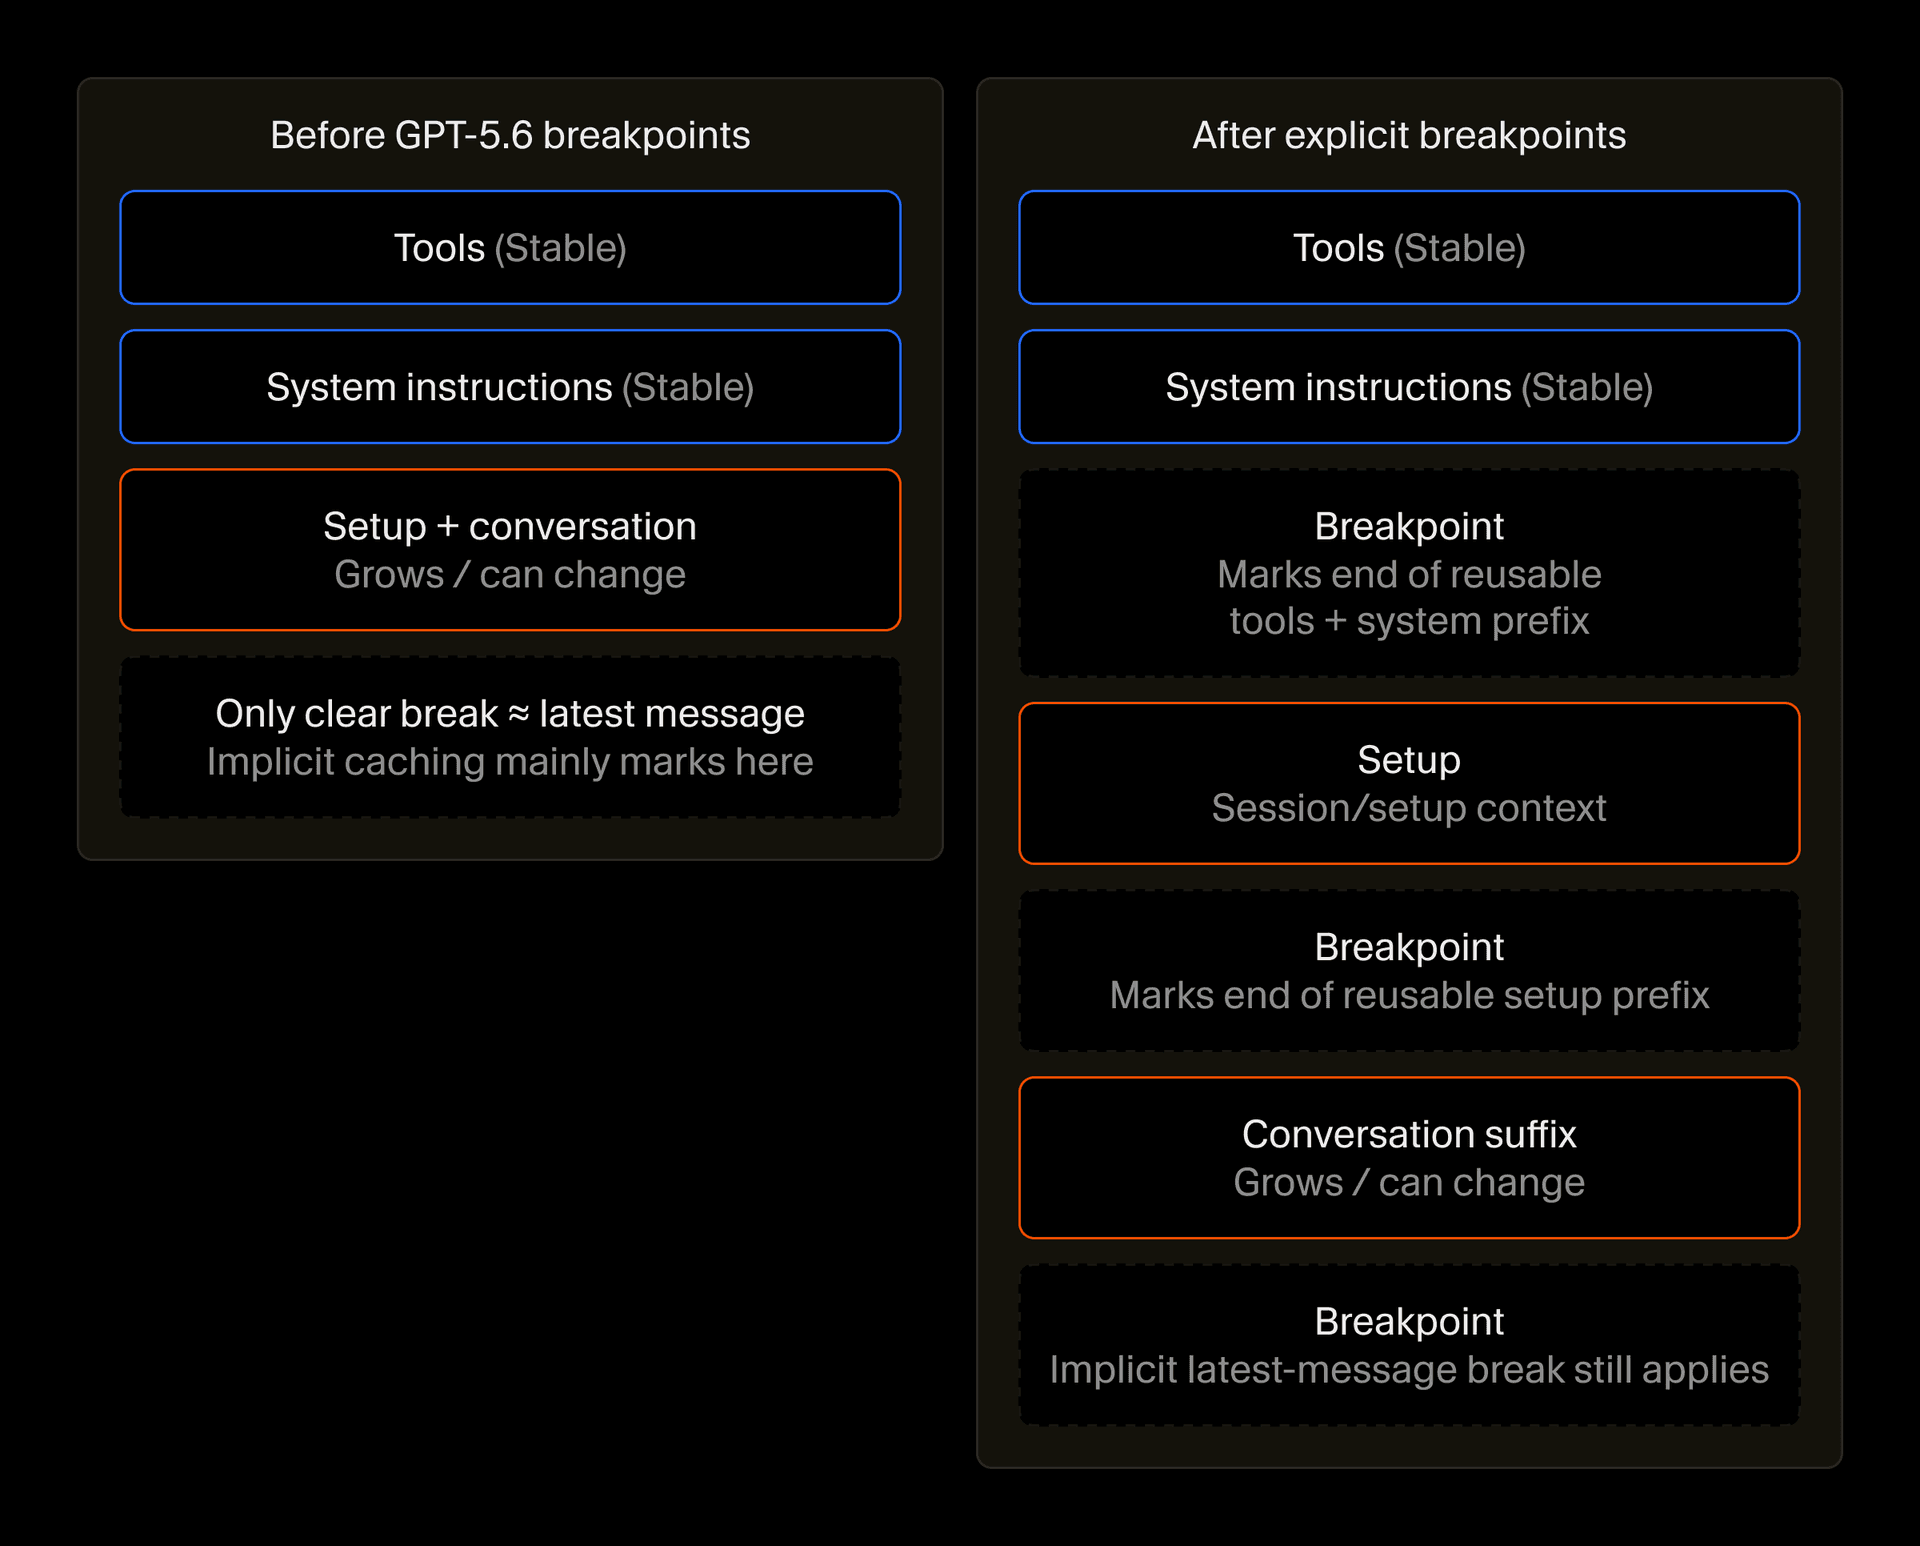
ब्रेकपॉइंट तभी काम आते हैं जब उपसर्ग खुद स्थिर बना रहे, इसलिए हमने यह भी कसकर तय किया कि हर अनुरोध की शुरुआत में क्या रहेगा। इसके लिए हमने उपकरण और सिस्टम निर्देशों को सिर्फ़ ऐसे Content के लिए आरक्षित किया जो कम ही बदलता है, और ज़्यादा परिवर्तनशील सेटअप को कैश सीमाओं से आगे अपने "फैंटम यूज़र मैसेज" में स्थानांतरित कर दिया। इसमें उपयोगकर्ता- और अनुरोध-विशिष्ट संदर्भ रहता है, जैसे कौशल, उप-एजेंट और परिवेश संबंधी जानकारी।
इन परिवर्तनों से कोल्ड cache misses की दर 20% घट गई।
फ़ाइल रीड को संपीड़ित करना
टोकन खर्च का एक और बड़ा स्रोत वह संदर्भ है जो एजेंट काम करते-करते जोड़ता जाता है, और इसका अधिकांश हिस्सा फ़ाइलें पढ़ने से आता है।
Cursor का एजेंट फ़ाइलों को Read टूल के ज़रिए पढ़ता है, जो परंपरागत रूप से हर पंक्ति को क्रमांकित करता था, क्योंकि मॉडल खुद से पंक्तियाँ गिनने में अच्छे नहीं होते और उन्हें उपयोगकर्ता के लिए विशिष्ट हिस्सों का हवाला देना पड़ता है।
एक पंक्ति संख्या में केवल तीन से पाँच टोकन ही लगते हैं, लेकिन जब कोई एजेंट एक सत्र के दौरान हज़ारों पंक्तियाँ पढ़ता है, तो हर एक को क्रमांकित करना संदर्भ में काफ़ी इज़ाफ़ा कर देता है।
हमने यह ओवरहेड घटाने के लिए पंक्ति संख्याएँ सिर्फ़ हर दसवीं पंक्ति पर देना शुरू किया। यह अब भी इतनी बार आती हैं कि मॉडल कोड का सही ढंग से हवाला दे सकें, और इस परिवर्तन से गुणवत्ता में बिना किसी कमी के कैश-रीड टोकन 1.6% घट गए।
उप-एजेंट का रणनीतिक उपयोग
लंबे एजेंट रन उप-एजेंट को काम सौंपने के अधिक अवसर देते हैं। इससे token खर्च घट सकता है, क्योंकि हर उप-एजेंट आमतौर पर पैरेंट एजेंट की पूरी बातचीत साथ ले जाने के बजाय एक नई कॉन्टेक्स्ट विंडो से शुरू होता है। जैसे ही वह अपने परिणाम रिपोर्ट कर देता है, पैरेंट उप-एजेंट के पूरे कार्यशील संदर्भ को साथ लिए बिना आगे बढ़ सकता है।
हालाँकि, एजेंट और उप-एजेंट के बीच इस तरह के कॉन्टेक्स्ट आइसोलेशन की एक समन्वय लागत भी चुकानी पड़ती है, क्योंकि जो एजेंट संदर्भ साझा नहीं करते, वे एक ही काम दोहरा सकते हैं या ऐसे कार्य कर सकते हैं जिनकी अब ज़रूरत ही नहीं है।
अनावश्यक समन्वय बढ़ाए बिना दक्षता का लाभ पाने के लिए हमने दो परिवर्तन किए। पहला, हमने वे निर्देश हटा दिए जो एजेंट्स को कोडबेस exploration के लिए उप-एजेंट इस्तेमाल करने पर ज़ोर देते थे। जैसे-जैसे उप-एजेंट प्रशिक्षण डेटा में अधिक प्रचलित हुए और शोधकर्ताओं ने उन्हें पोस्ट-ट्रेनिंग में शामिल किया, मॉडल ने यह पैटर्न स्वाभाविक रूप से सीख लिया। अतिरिक्त प्रॉम्प्टिंग हटाने से उप-एजेंट का उपयोग अधिक संतुलित हो गया।
हमने यह भी कसा कि उप-एजेंट मॉडल कैसे चुनते हैं। Cursor हमारे किसी भी उपलब्ध मॉडल का इस्तेमाल करके उप-एजेंट स्पॉन कर सकता है, जिससे अलग-अलग मॉडलों की कमियों की भरपाई करना या एक महँगे योजना मॉडल को कार्यान्वयन के लिए किसी सस्ते मॉडल के साथ जोड़ना संभव होता है। हमने टूल आर्ग्युमेंट्स को अपडेट किया, ताकि एजेंट कोई अलग मॉडल तभी चुनें जब उपयोगकर्ता या उपयोग में लाने के निर्देश ऐसा निर्देश दें।
उपयोग में लाने की दक्षता में सुधार जारी
हम यह मापना जारी रखेंगे कि लंबे रन के दौरान संदर्भ कैसे जमा होता है, और यह परखते रहेंगे कि उपयोग में लाना कहाँ एजेंट की गुणवत्ता पर असर डाले बिना दोहराए जाने वाले प्रसंस्करण को घटा सकता है। समय के साथ हमें उम्मीद है कि इससे token उपयोग, एजेंट जितनी कृति पूरी कर सकते हैं उसकी तुलना में कहीं धीमी गति से बढ़ेगा। ये सीख हमने Grok Bot पर भी लागू की हैं, जहाँ हम उसके विशिष्ट उपयोग में लाने को अनुकूलित करने पर काम कर रहे हैं ताकि उपयोगकर्ता सबसे कम लागत पर सबसे अधिक कृति पूरी कर सकें।


