Mayor eficiencia de tokens en ejecuciones de agente más largas


A medida que los agentes han madurado y han aprendido a abordar tareas más ambiciosas, el gasto de tokens ha cambiado. Ahora los agentes trabajan durante más tiempo y arrastran más contexto de un paso al siguiente, por lo que la forma en que componemos y gestionamos ese contexto es cada vez más importante.
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
Notas: «Definiciones de sistema y herramientas» incluye los resúmenes de compactación. «Texto del usuario» incluye los skills adjuntados manualmente. «Skills y plugins» incluye las descripciones de skills, las descripciones de herramientas MCP y las reglas que se incorporan al contexto estático.
En los últimos meses hemos respondido a este cambio mejorando la eficiencia del harness de agentes de Cursor. El harness nos proporciona control directo sobre cómo se arma cada solicitud, cómo se reutiliza el contexto y cuándo se reparte el trabajo entre agentes. Los cambios en cada una de estas capas redujeron un 7 % el costo de tokens para los usuarios sin sacrificar la calidad del agente.
Recortar el prompt del sistema
Cada turno del agente incluye contexto que Cursor proporciona antes de que el modelo empiece a trabajar. Esto abarca el prompt del sistema y las definiciones de las herramientas que el agente puede usar. Como ese contexto se incluye a lo largo de toda la conversación, se había convertido en una de las mayores fuentes de gasto que controlamos por completo.
Cuando los modelos eran menos capaces, teníamos que detallar instrucciones sobre el uso de herramientas, la gestión de tareas y los flujos de trabajo de cambios de código. También debíamos protegernos frente a comportamientos extraños, como volcados de hashes larguísimos, resultados binarios y emojis.
A medida que los modelos mejoraron, buena parte de esas indicaciones dejó de ser necesaria. En lugar de largas listas de instrucciones del tipo «NO hagas esto», «Debes» o «Importante», bastaba con definir cómo se comporta una herramienta y, por lo general, los modelos lo cumplían. Esto ocurrió en todas las familias de modelos, lo que nos permitió recortar cerca del 66 % de nuestro prompt del sistema.
Con el tiempo, seguimos agregando y quitando instrucciones a medida que los nuevos modelos requieren nuevas indicaciones, que luego se incorporan al entrenamiento de los modelos futuros. Aprovechar las pruebas A/B con una base de usuarios amplia es fundamental para optimizar el harness de forma eficaz para el tráfico real. Aunque los evals pueden ser un proxy rápido y útil, a menudo representan problemas «difíciles» y no reflejan bien la distribución real de las solicitudes de los usuarios.
Cargar herramientas solo cuando se necesitan
El prompt del sistema es solo una parte del contexto que Cursor aporta en cada turno. Otra son las definiciones de herramientas, que habían crecido enormemente a lo largo del año a medida que incorporábamos capacidades más potentes al agente Cursor, como la monitorización de shells en segundo plano, los subagentes en Cloud y un acceso más fiable al contenido web. La mayoría de estas herramientas son importantes, pero cada una se necesita en menos del 20 % de las conversaciones.
Ahí surgió la oportunidad de mejorar la eficiencia manteniendo las herramientas disponibles sin incluir sus definiciones completas en cada solicitud. Ya habíamos resuelto un problema parecido a principios de este año, cuando trasladamos las herramientas MCP al contexto dinámico y empezamos a cargarlas solo cuando hacían falta. Esto redujo los tokens totales en un 46,9 % en las sesiones que invocaban una herramienta MCP.
Ahora hemos aplicado la misma técnica a nuestras propias herramientas integradas.
Para decidir qué herramientas mantener en el contexto estático, hicimos pruebas A/B con varias configuraciones según la frecuencia de uso de cada herramienta y según si los modelos necesitaban verla desde el principio. Registramos el uso de tokens, el costo, la latencia, los errores en las llamadas a herramientas y el uso general del agente para asegurarnos de que el ahorro no afectara a la calidad.
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
Al final, mantuvimos en el contexto estático las herramientas de alta frecuencia para leer, buscar, editar y usar el shell. También conservamos ask_question, cuyas llamadas algunos modelos tendían a alucinar, y las herramientas cruciales para flujos específicos del producto, como create_plan en el modo Plan. El resto de las herramientas ahora se cargan cuando el agente las necesita.
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
Mejorar la reutilización de la caché
Tras reducir la cantidad de contexto estático en cada solicitud, mejoramos la eficacia con la que el contexto repetido podía almacenarse en caché entre turnos.
Cada turno del agente reenvía una solicitud extensa que contiene herramientas, instrucciones del sistema, configuración y la conversación hasta ese momento. Gran parte del inicio se mantiene igual de un turno al siguiente, mientras que la conversación del final sigue creciendo.
El almacenamiento en caché del prompt permite que el proveedor del modelo reutilice ese prefijo sin cambios. Sin embargo, las opciones de configuración de la caché varían según el proveedor. Antes de GPT-5.6, el perímetro de la caché se determinaba automáticamente en función de la última solicitud. Aunque las herramientas y las instrucciones del sistema rara vez cambiaban, no quedaban marcadas de forma clara como reutilizables por sí mismas.
Desde GPT-5.6, la API de OpenAI permite que los clientes marquen puntos de corte de caché explícitos junto con su almacenamiento en caché implícito por defecto. Ahora colocamos esos puntos de corte después de las capas estables de la solicitud y antes de la conversación en crecimiento, lo que permite que los turnos posteriores reutilicen una mayor parte del prefijo sin cambios.
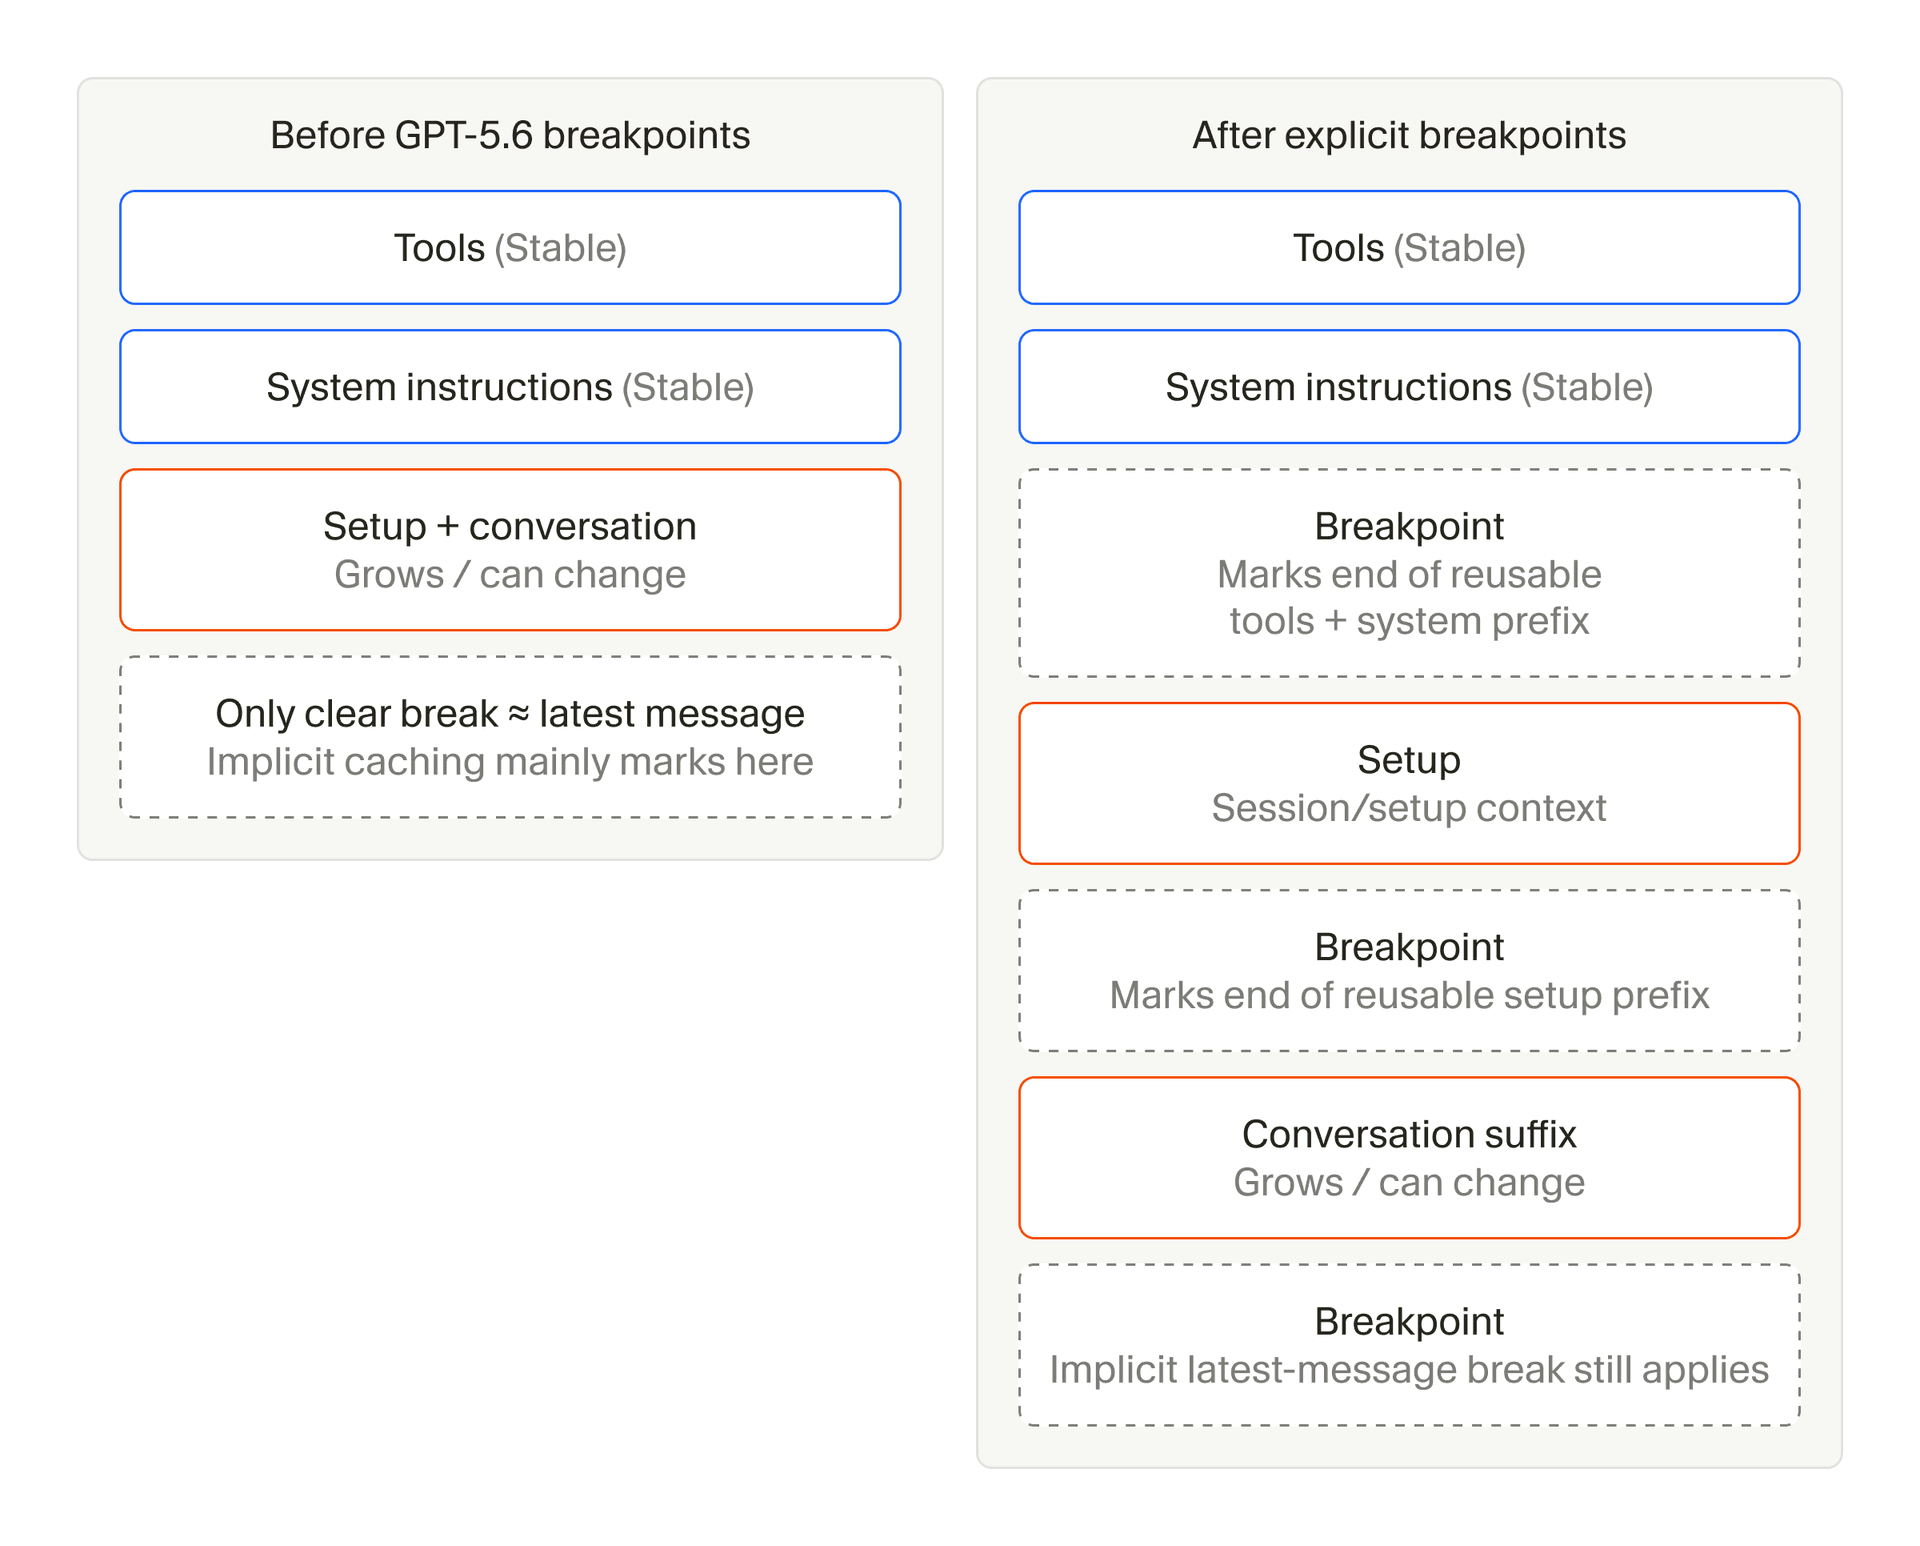
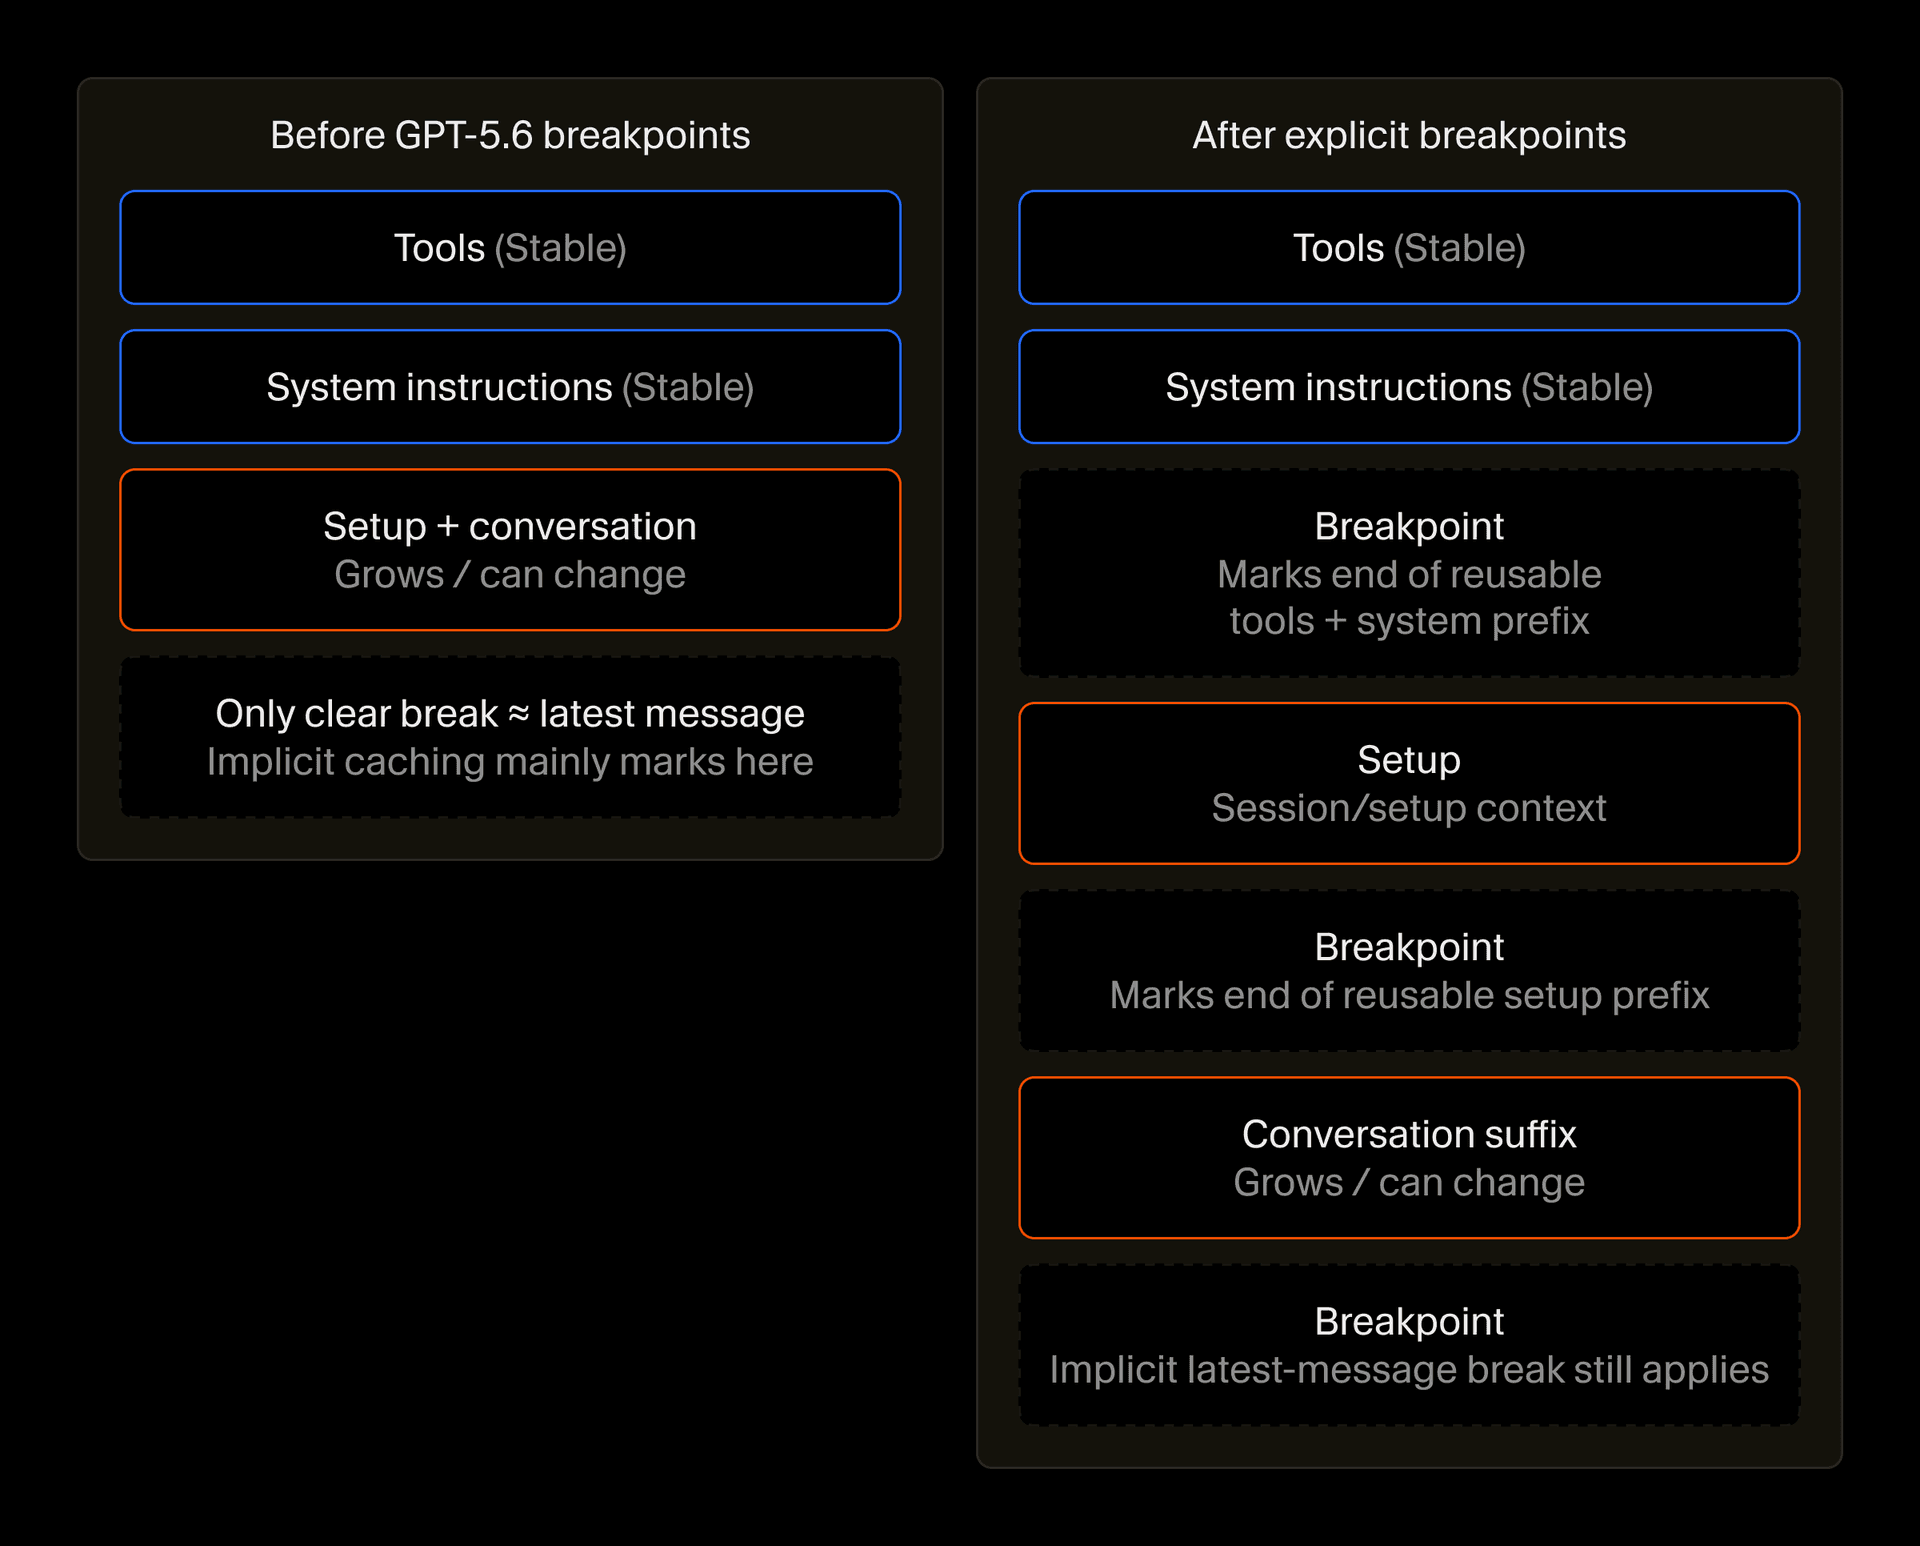
Los puntos de corte de caché solo sirven si el prefijo en sí se mantiene estable, así que también depuramos lo que va al inicio de cada solicitud. Para ello, reservamos las herramientas y las instrucciones del sistema para contenido que rara vez cambia, y desplazamos la configuración más variable más allá de los límites de la caché, hacia nuestro "mensaje de usuario fantasma". Ahí se aloja el contexto específico del usuario y de la solicitud, como skills, subagentes e información del entorno.
Estos cambios redujeron un 20 % la tasa de fallos de caché en frío.
Compresión de lecturas de archivos
Otra fuente importante de gasto de tokens es el contexto que un agente va agregando mientras trabaja, gran parte del cual proviene de la lectura de archivos.
El agente de Cursor lee archivos mediante una herramienta Read que, tradicionalmente, numeraba cada línea, ya que los modelos no son buenos contando líneas por sí solos y necesitan citar secciones específicas al usuario.
Un solo número de línea consume apenas entre tres y cinco tokens, pero cuando un agente lee decenas de miles de líneas en una sesión, numerarlas todas suma una cantidad nada despreciable de contexto.
Redujimos esa sobrecarga incluyendo números solo cada diez líneas. Sigue siendo lo bastante frecuente para que los modelos citen el código correctamente, y el cambio redujo los tokens de lectura de caché en un 1,6 % sin ninguna pérdida de calidad.
Uso estratégico de los subagentes
Cuanto más largas son las ejecuciones de un agente, más oportunidades hay de delegar trabajo en subagentes. Esto puede reducir el gasto de tokens, porque cada subagente suele empezar con una ventana de contexto nueva en lugar de arrastrar toda la conversación del agente principal. Una vez que este informa de sus resultados, el agente principal puede seguir adelante sin cargar con todo el contexto de trabajo del subagente.
Sin embargo, este tipo de aislamiento del contexto entre agentes y subagentes sí tiene un costo de coordinación, ya que los agentes que no comparten contexto pueden duplicar trabajo o emprender tareas que ya no hacen falta.
Hicimos dos cambios para aprovechar las ventajas de eficiencia sin sumar coordinación innecesaria. Primero, eliminamos las instrucciones que animaban con insistencia a los agentes a usar subagentes para explorar la base de código. A medida que los subagentes se volvieron más habituales en los datos de entrenamiento y los investigadores los incorporaron al post-entrenamiento, los modelos aprendieron este patrón de forma nativa. Quitar ese prompt adicional dio lugar a un uso más equilibrado de los subagentes.
También afinamos la forma en que los subagentes seleccionan modelos. Cursor puede generar subagentes con cualquiera de nuestros modelos disponibles, lo que permite compensar los puntos ciegos de unos modelos con otros o combinar un modelo de planificación costoso con uno más económico para la implementación. Actualizamos los argumentos de la herramienta para que los agentes elijan un modelo distinto solo cuando lo indique el usuario o el harness.
Seguimos mejorando la eficiencia del harness
Continuaremos midiendo cómo se acumula el contexto en ejecuciones más largas y analizando en qué puntos el harness puede reducir el procesamiento repetido sin afectar a la calidad del agente. Con el tiempo, esperamos que esto haga que el uso de tokens crezca mucho más despacio que la cantidad de trabajo que los agentes son capaces de completar. También hemos trasladado estos aprendizajes al Bot de Grok, donde estamos optimizando su harness particular para que los usuarios puedan hacer el mayor trabajo posible al menor costo.


