提升長時間 代理 run 的 token 效率


隨著 代理 日趨成熟、能夠處理更具挑戰性的任務,token 的耗用形態也隨之改變。如今 代理 運行的時間更長,並在各個步驟之間承載更多上下文,這讓我們組織與管理上下文的方式變得愈發重要。
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
說明:系統與工具定義包含 compaction 摘要。使用者文字包含手動附加的 技能。技能 與外掛程式包含 技能 說明、MCP 工具說明,以及放入 靜態上下文 的規則。
過去幾個月,我們為因應這項轉變,著手提升 Cursor 代理 工具鏈的效率。工具鏈讓我們能直接掌控每個請求的組成方式、上下文的重複利用方式,以及何時將工作分配給多個 代理。這幾個層面的變更,讓使用者的 token 成本降低了 7%,且未犧牲 代理 品質。
精簡系統提示詞
每一次代理對話輪次,在模型開始work之前都會先帶入 Cursor 提供的上下文,其中包含系統提示詞,以及代理可使用工具的定義。由於這些上下文會貫穿整段對話,它已成為我們能完全掌控的最大開銷來源之一。
在模型能力還不夠強的時期,我們必須把工具用法、任務管理與程式碼修改工作流程的指示一條條寫清楚,還得防範一些奇怪的行為,例如極長的雜湊值傾印、二進位輸出與表情符號。
隨著模型改進,這些叮嚀大多已不再必要。我們不必再列出一長串「請勿這樣做」、「你必須」或「重要」之類的指示,只要定義好工具的行為,模型通常就會照做。各個模型家族皆是如此,因此我們得以精簡約 66% 的系統提示詞。
隨著時間推移,我們仍會持續增減指示,因為新模型需要新的指引,而這些指引又會回饋到未來模型的訓練之中。想要針對真實流量有效地最佳化工具鏈,在龐大的使用者基礎上進行 A/B 測試至關重要。evals 雖然是快速又實用的替代衡量方式,但它們往往代表的是「困難」的問題,無法確實反映使用者請求的真實分布。
只在需要時載入工具
系統提示詞只是 Cursor 每一輪所提供上下文的其中一部分,另一部分則是工具定義。隨著我們為 Cursor 代理加入更多強大能力——包括背景 shell 監控、雲端子代理,以及更可靠地取得網頁內容——工具定義在這一年間大幅膨脹。這些工具大多很重要,但每一項實際上只有不到 20% 的對話會用到。
這帶來了一個提升效率的機會:讓工具維持可使用,卻不必在每次請求都附上完整定義。今年稍早我們已解決過類似的問題,當時將 MCP 工具移入動態上下文,只在需要時才載入,讓有呼叫 MCP 工具的工作階段總 token 數減少了 46.9%。
如今我們把同樣的做法套用到自家的內建工具上。
為了決定哪些工具要保留在靜態上下文中,我們依據各工具的使用頻率,以及模型是否需要從一開始就看到它,對多種組態進行 A/B 測試。我們追蹤 token 用量、成本、延遲、工具呼叫錯誤與整體代理用量,以確保省下的開銷不會犧牲品質。
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
最終,我們把用於讀取、搜尋、編輯與操作 shell 的高頻工具保留在靜態上下文中,同時也保留了 ask_question (部分模型容易幻覺出對它的呼叫) ,以及對特定產品流程至關重要的工具,例如規劃模式中的 create_plan。其餘工具現在則會在代理需要時才載入。
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
改進快取重用
在減少每次請求中的靜態上下文之後,我們進一步改進了重複上下文在多個對話輪次之間的快取效率。
每個代理對話輪次都會重新送出一個很長的請求,內容包含工具、系統指示、設定,以及目前為止的對話。從這一輪到下一輪,開頭的大部分內容都維持不變,而結尾的對話則持續增長。
提示詞快取讓模型供應商能夠重用這段未變動的前綴。不過,快取的可設定程度會因供應商而異。在 GPT-5.6 之前,快取邊界是依據最新的請求自動決定的;即使工具與系統指示很少變動,它們本身也沒有被明確標記為可重用。
自 GPT-5.6 起,OpenAI API 允許客戶端在預設的隱含快取之外,另行標記明確的快取中斷點。我們現在會將中斷點放在請求中穩定層之後、持續增長的對話之前,讓後續輪次能重用更多未變動的前綴。
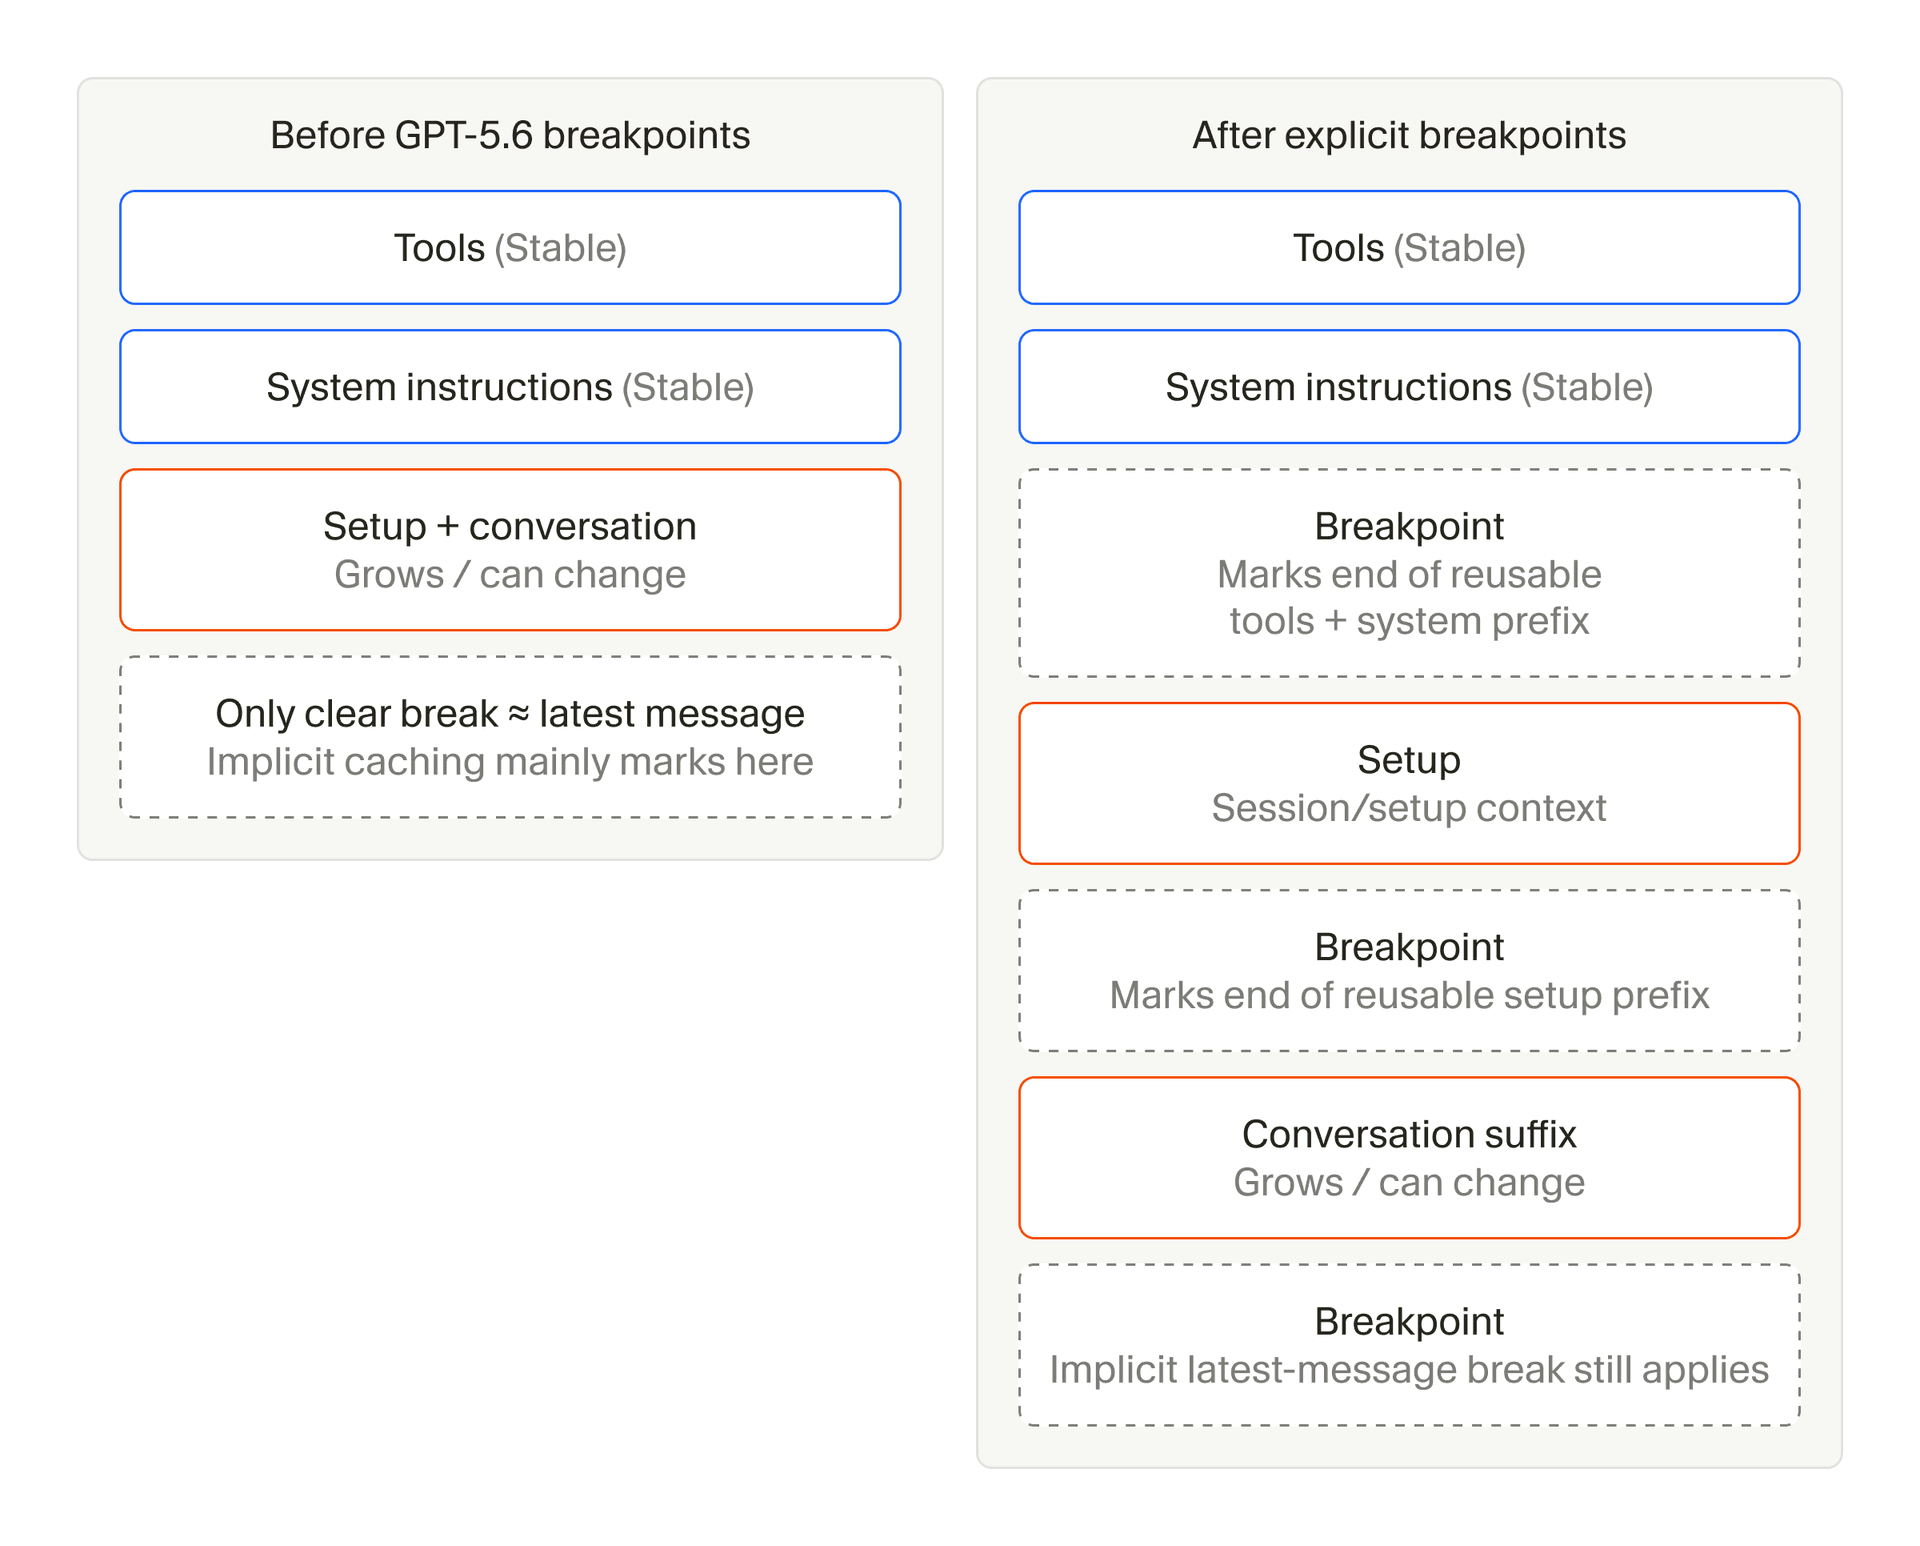
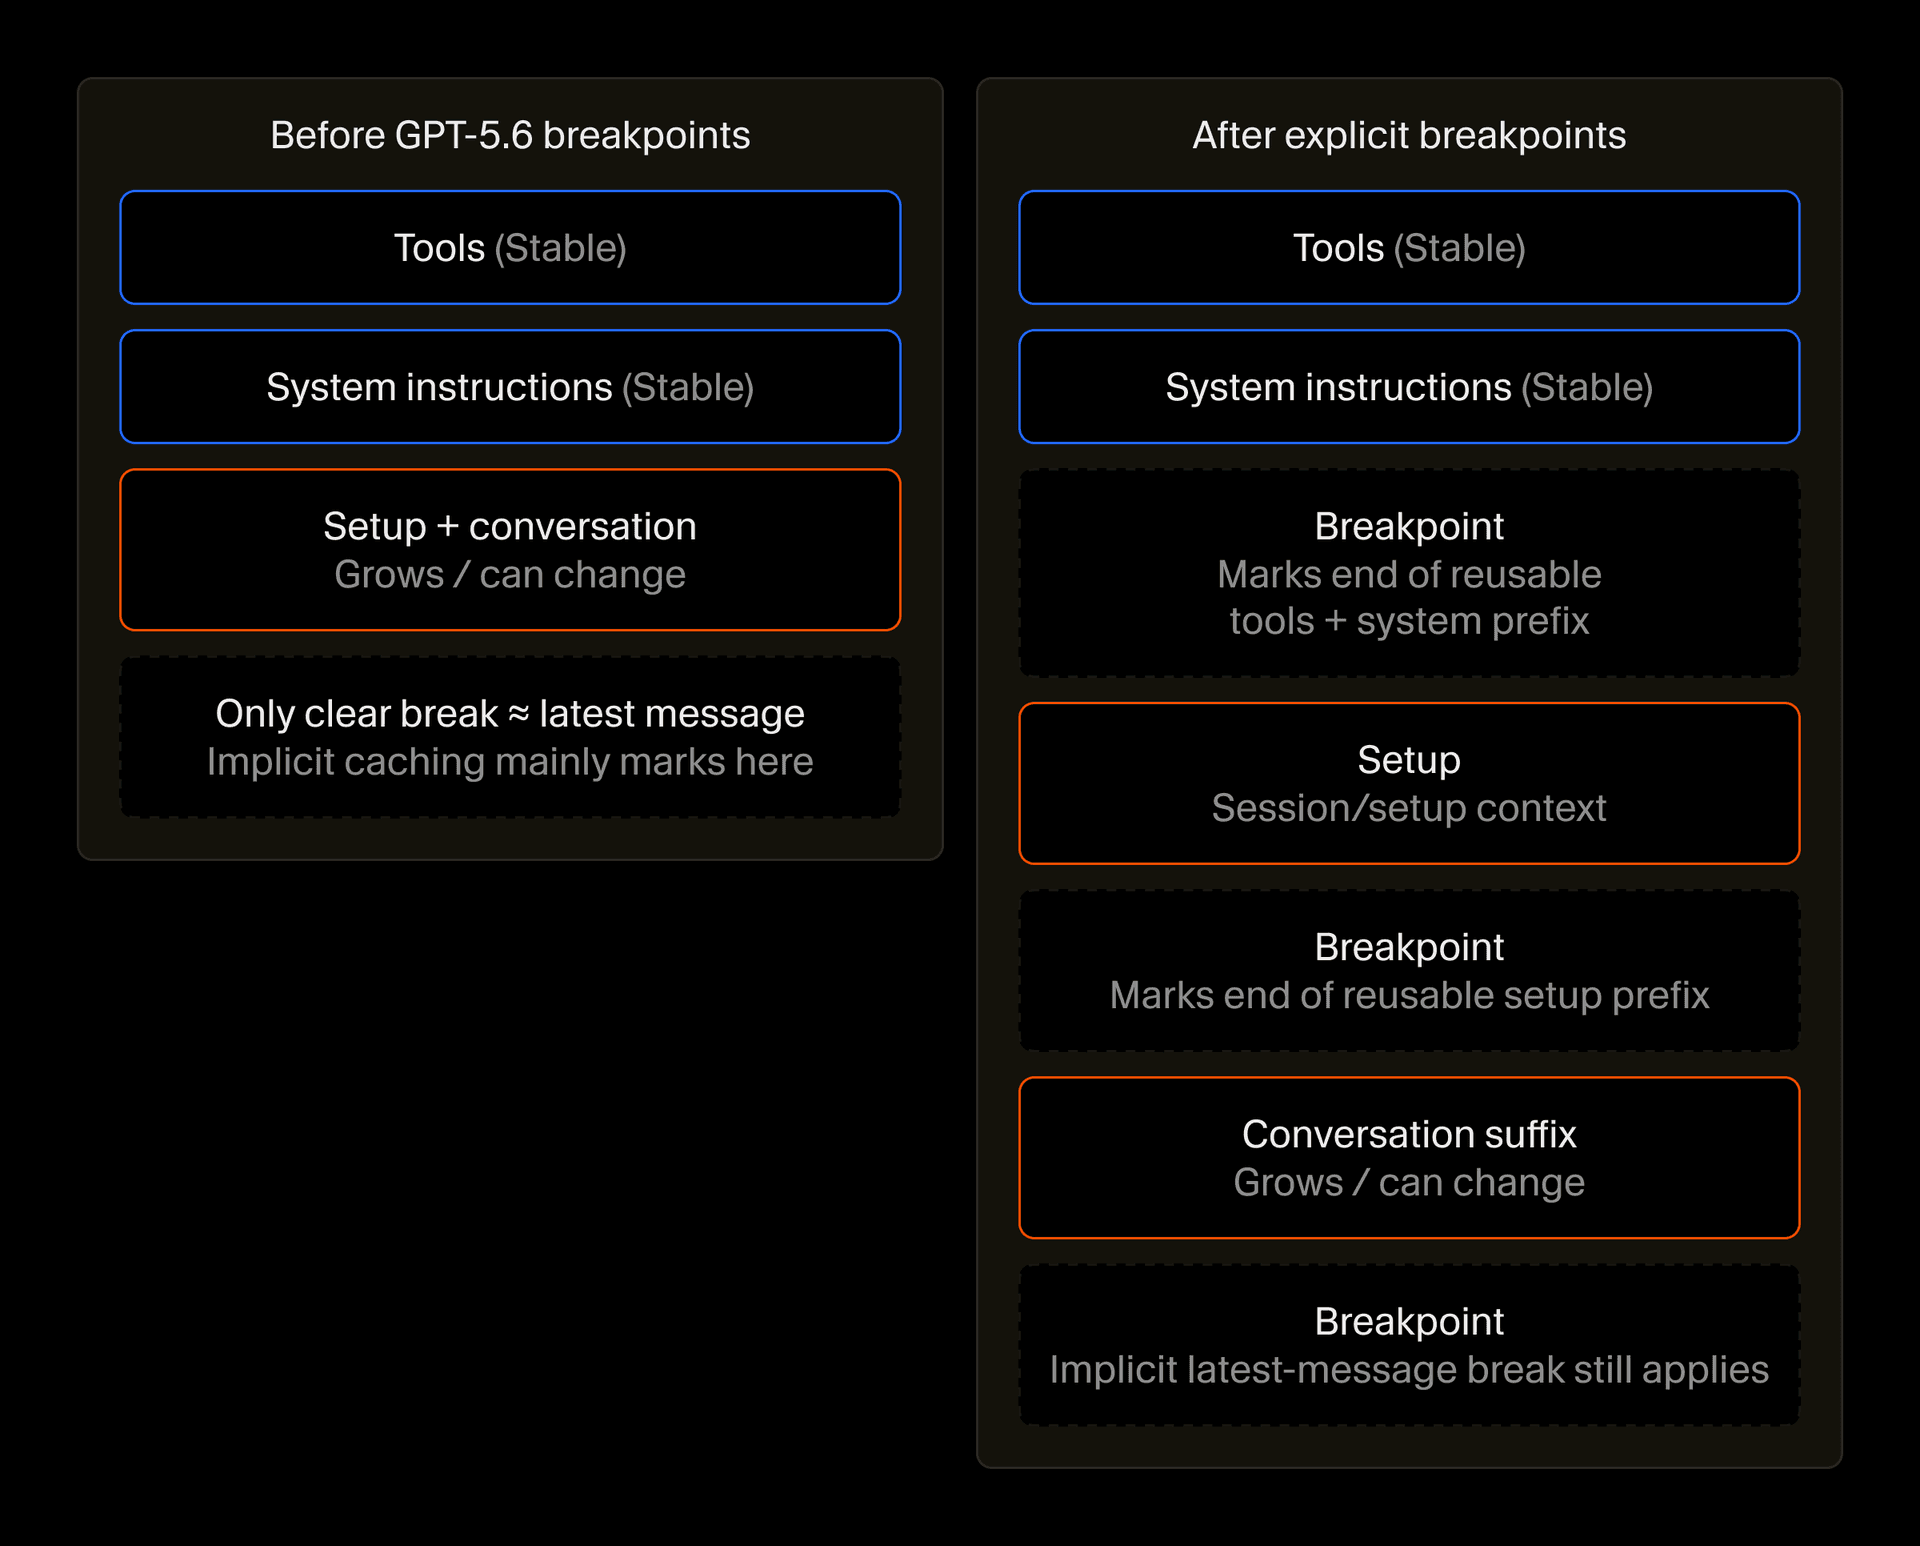
只有在前綴本身維持穩定時,中斷點才能發揮作用,因此我們也收緊了每個請求開頭所放置的內容。具體做法是:讓工具與系統指示只保留極少變動的內容,並將變動性較高的設定移到快取邊界之後,放進我們所謂的"幻影使用者訊息"中,用來承載使用者與請求專屬的上下文,例如技能、子代理與環境資訊。
這些變更讓冷快取未命中的比率降低了 20%。
壓縮檔案讀取
另一個大量消耗 token 的來源,是代理在工作過程中持續加入的上下文,其中多數來自讀取檔案。
Cursor 的代理透過 Read 工具讀取檔案,過去會為每一行標上行號,因為模型本身不擅長自行數行,且需要為使用者引用特定段落。
單一行號僅耗用約三到五個 token,但當代理在一個工作階段中讀取數萬行程式碼時,逐行編號就會累積出相當可觀的上下文量。
我們改為每十行才標一次行號,藉此降低這項額外開銷。這樣的頻率仍足以讓模型正確引用程式碼,而這項調整讓快取讀取的 token 減少了 1.6%,品質也未因此下降。
策略性地運用子代理
代理 run 的時間拉長,就有更多機會把工作委派給子代理。這能減少 token 花費,因為每個子代理通常都是從全新的 上下文 window 開始,而不是延續 parent 代理的完整 conversation。等子代理回報結果後,parent 就能接著往下做,不必承載子代理的完整工作上下文。
不過,代理 與子代理之間的這種上下文 isolation 確實有協調成本,因為彼此不共享上下文的代理可能重複做同樣的工作,或去執行已不再必要的 task。
為了取得效率上的好處又不增加多餘的協調,我們做了兩項變更。首先,我們移除了強烈鼓勵代理 使用子代理進行 codebase exploration 的指示。隨著子代理在訓練資料中愈來愈常見,研究人員也將其納入 post-training,模型已原生學會這個 pattern。拿掉額外的 prompting 之後,子代理的用量反而更為均衡。
我們也收緊了子代理挑選模型的方式。Cursor 可以使用我們任何一個可使用的模型來 spawn 子代理,因此可以互相彌補不同模型的盲點,或是用昂貴的 planning 模型搭配較便宜的模型來做 implementation。我們更新了工具參數,讓代理只有在 user 或工具鏈指示時才改用不同的模型。
持續提升工具鏈效率
我們會持續觀察上下文在長時間執行過程中的累積情形,並測試工具鏈可以在哪些環節減少重複處理,同時不影響代理的品質。長期而言,我們預期這能讓 token 用量的成長幅度遠低於代理所能完成的工作量。我們也把這些經驗帶到了 Grok Bot,正著手最佳化其獨特的工具鏈,讓使用者能以最低的成本完成最多的工作。


