Maior eficiência de tokens para execuções de agente mais longas


À medida que os agentes amadureceram e aprenderam a executar tarefas mais ambiciosas, o gasto de token mudou. Agora os agentes trabalham por mais tempo e levam mais contexto de uma etapa para a outra, o que torna cada vez mais importante a forma como montamos e gerenciamos esse contexto.
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
Observações: as definições de sistema e ferramentas incluem resumos de compactação. O texto do usuário inclui habilidades anexadas manualmente. Habilidades e plugins incluem descrições de habilidades, descrições de ferramentas MCP e regras que entram no contexto estático.
Nos últimos meses, respondemos a essa mudança melhorando a eficiência do harness de agente do Cursor. O harness nos dá controle direto sobre como cada requisição é montada, como o contexto é reaproveitado e quando o trabalho é dividido entre agentes. Alterações em cada uma dessas camadas reduziram em 7% os custos de tokens para os usuários, sem perda na qualidade do agente.
Enxugando o prompt do sistema
Todo turno do agente inclui um contexto fornecido pelo Cursor antes de o modelo começar a trabalhar. Isso abrange o prompt do sistema e as definições das ferramentas que o agente pode usar. Como esse contexto acompanha toda a conversa, ele havia se tornado uma das maiores fontes de gasto sobre as quais temos controle total.
Quando os modelos eram menos capazes, precisávamos detalhar instruções sobre uso de ferramentas, gerenciamento de tarefas e fluxos de trabalho de alteração de código. Também precisávamos nos precaver contra comportamentos estranhos, como despejos de hash extremamente longos, saída binária e emojis.
À medida que os modelos evoluíram, boa parte dessas orientações se tornou desnecessária. Em vez de longas listas de instruções do tipo "NÃO faça isso", "Você deve" ou "Importante", bastava definir como uma ferramenta se comporta e, em geral, os modelos obedeciam. Isso valeu para todas as famílias de modelos, o que nos permitiu enxugar cerca de 66% do nosso prompt do sistema.
Com o tempo, seguimos adicionando e removendo instruções conforme novos modelos exigem novas orientações, que depois alimentam o treinamento dos modelos futuros. Aproveitar testes A/B em uma base ampla de usuários é fundamental para otimizar o harness de forma eficaz para o tráfego real. Embora as evals possam ser um substituto rápido e útil, elas costumam representar problemas "difíceis" e não refletem adequadamente a verdadeira distribuição das solicitações dos usuários.
Carregando ferramentas apenas quando necessário
O prompt do sistema é apenas uma parte do contexto que o Cursor fornece a cada turno. Outra são as definições de ferramentas, que cresceram drasticamente ao longo do ano conforme adicionamos capacidades mais poderosas ao agente do Cursor, incluindo monitoramento de shell em segundo plano, subagentes na nuvem e acesso mais confiável a conteúdo da web. A maioria dessas ferramentas é importante, mas cada uma delas é necessária em menos de 20% das conversas.
Isso abriu uma oportunidade de melhorar a eficiência mantendo as ferramentas disponíveis sem incluir suas definições completas em cada requisição. Já havíamos resolvido um problema parecido no início deste ano, quando movemos as ferramentas MCP para o contexto dinâmico, carregando-as apenas quando necessário. Isso reduziu o total de tokens em 46,9% nas sessões que chamaram uma ferramenta MCP.
Agora aplicamos a mesma técnica às nossas próprias ferramentas integradas.
Para decidir quais ferramentas manter no contexto estático, testamos várias configurações em testes A/B, considerando a frequência de uso de cada ferramenta e se os modelos precisavam vê-la desde o início. Acompanhamos o uso de tokens, o custo, a latência, os erros de chamada de ferramenta e o uso geral do agente para garantir que a economia não comprometesse a qualidade.
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
No fim, mantivemos no contexto estático as ferramentas de alta frequência para leitura, busca, edição e uso do shell. Também mantivemos a ask_question, para a qual alguns modelos tendiam a alucinar chamadas, e ferramentas cruciais para fluxos específicos do produto, como a create_plan no Plan Mode. As demais ferramentas agora são carregadas quando o agente precisa delas.
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
Melhorando o reaproveitamento de cache
Depois de reduzir a quantidade de contexto estático em cada requisição, melhoramos a eficácia com que o contexto repetido pode ser armazenado em cache entre os turnos.
Cada turno do agente reenvia uma requisição longa contendo ferramentas, instruções de sistema, configuração e a conversa até aquele ponto. Boa parte do início permanece igual de um turno para o outro, enquanto a conversa no final continua crescendo.
O cache de prompts permite que o provedor do modelo reaproveite esse prefixo inalterado. No entanto, as opções de configuração do cache podem variar conforme o provedor. Antes do GPT-5.6, o limite do cache era determinado automaticamente com base na requisição mais recente. Mesmo que as ferramentas e as instruções de sistema raramente mudassem, elas não eram marcadas de forma clara como reutilizáveis por si só.
Desde o GPT-5.6, a API da OpenAI permite que os clientes marquem breakpoints de cache explícitos junto com seu cache implícito padrão. Agora colocamos esses breakpoints depois das camadas estáveis da requisição e antes da conversa em crescimento, permitindo que turnos posteriores reaproveitem mais do prefixo inalterado.
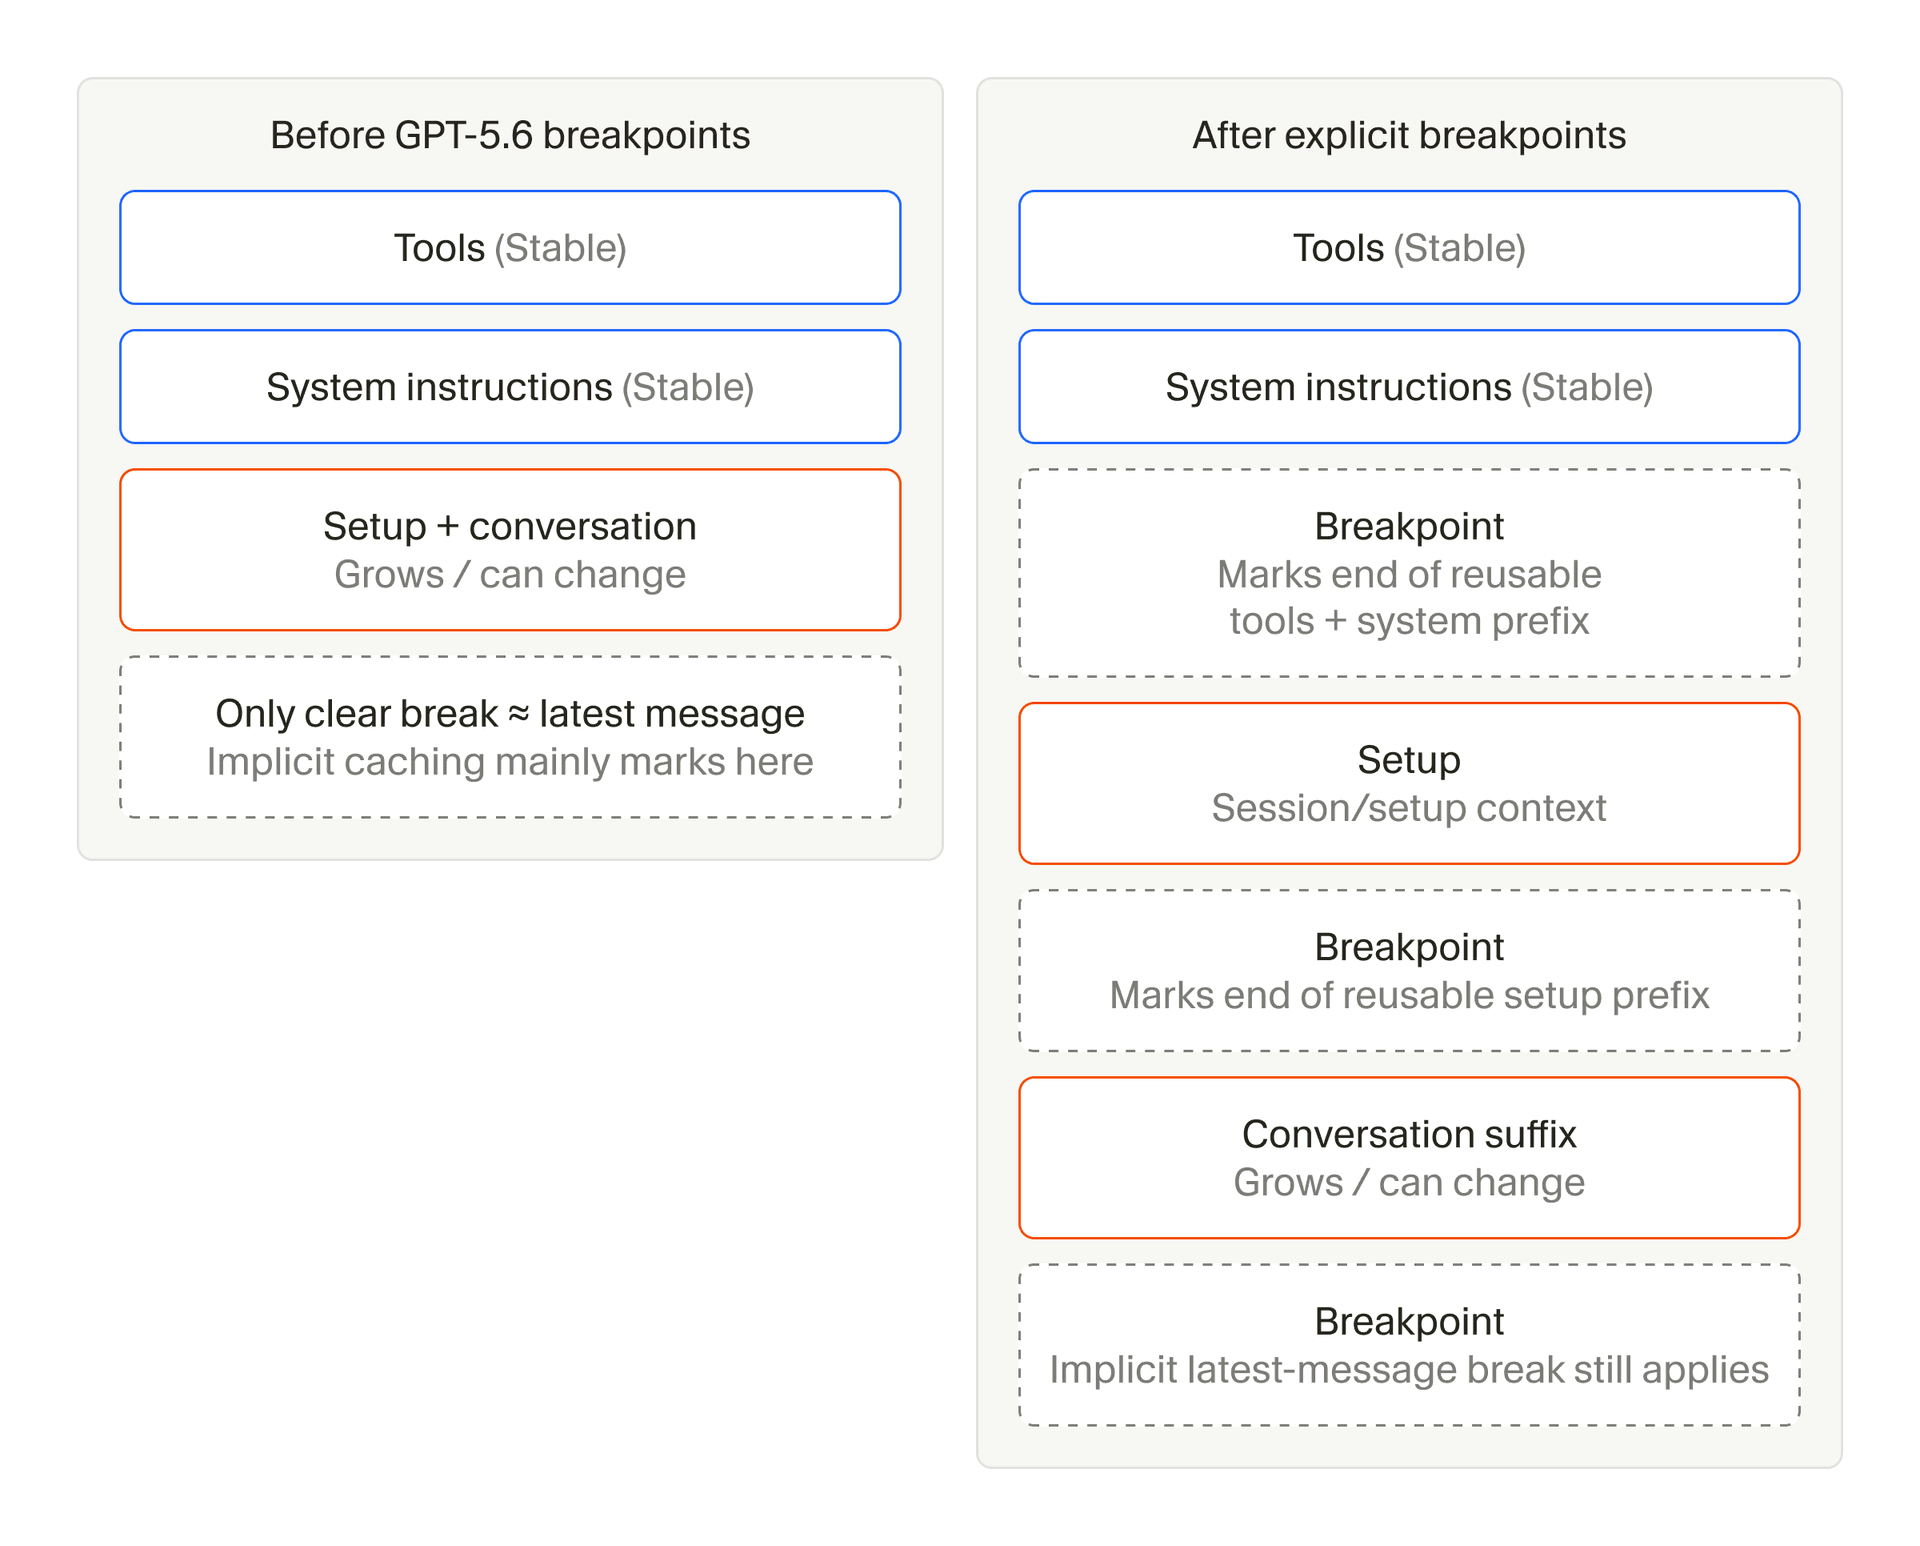
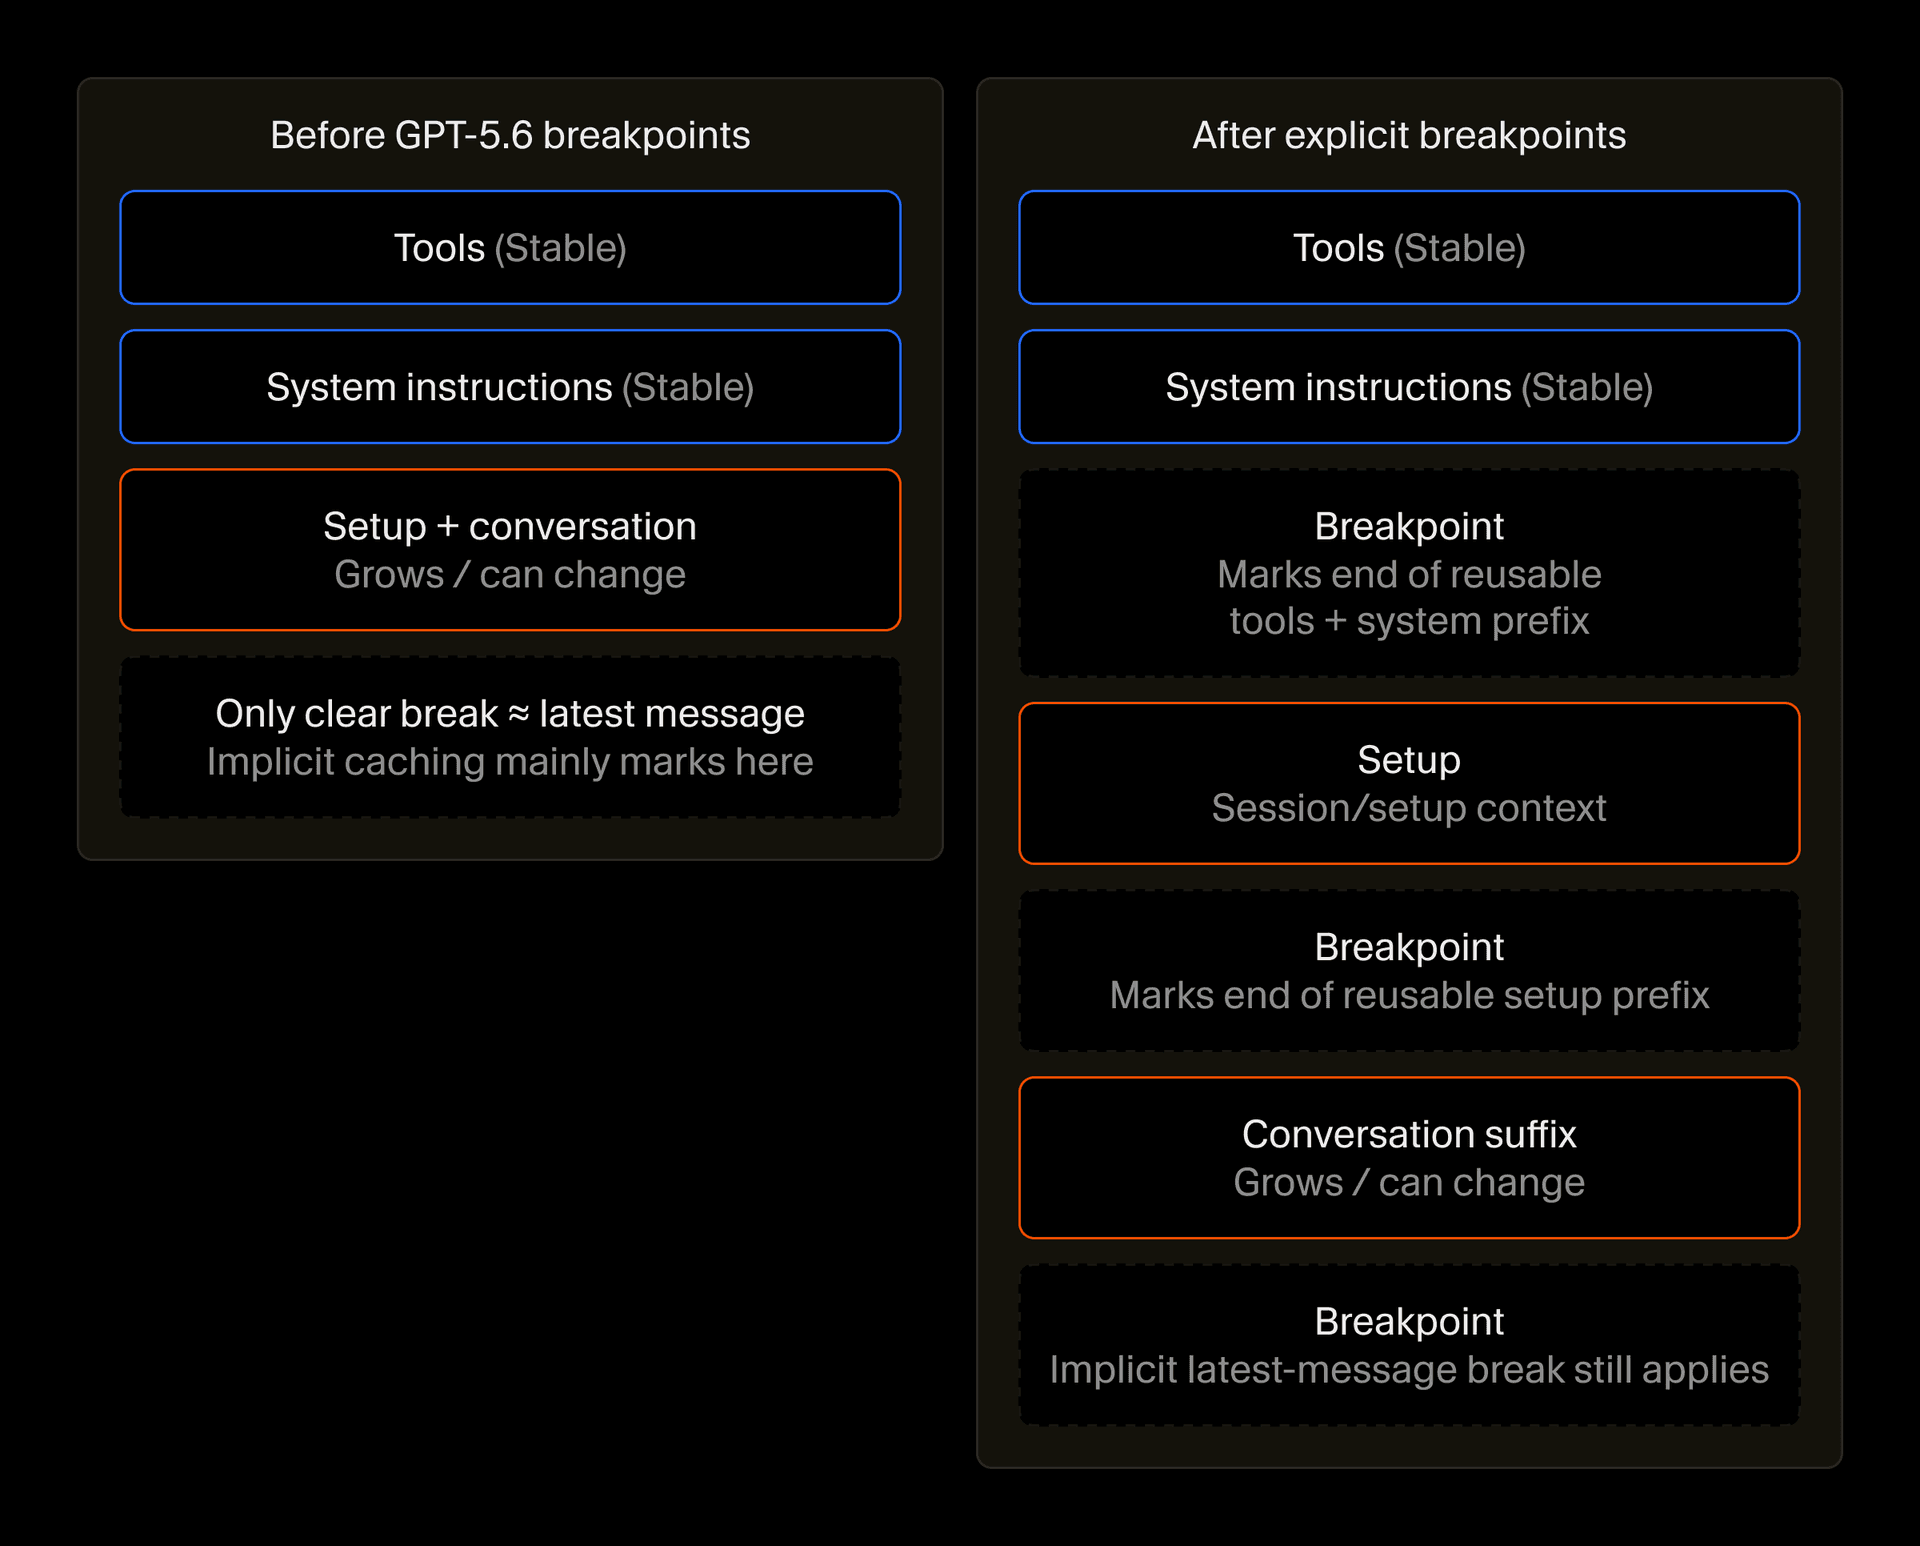
Os breakpoints só ajudam se o próprio prefixo permanecer estável, então também organizamos melhor o que fica no início de cada requisição. Para isso, reservamos as ferramentas e as instruções de sistema para conteúdo que raramente muda e movemos a parte mais variável da configuração para além dos limites do cache, para dentro da nossa "phantom user message". É ela que guarda o contexto específico do usuário e da requisição, como habilidades, subagentes e informações de ambiente.
Essas mudanças reduziram em 20% a taxa de cache misses frios.
Compressão de leituras de arquivos
Outra grande fonte de gasto de tokens é o contexto que um agente acrescenta enquanto trabalha, boa parte dele vindo da leitura de arquivos.
O agente do Cursor lê arquivos por meio de uma ferramenta Read, que tradicionalmente numerava todas as linhas, já que os modelos não são bons em contar linhas sozinhos e precisam citar trechos específicos para o usuário.
Um único número de linha consome apenas cerca de três a cinco tokens, mas quando um agente lê dezenas de milhares de linhas em uma sessão, numerar cada uma delas acrescenta uma quantidade considerável de contexto.
Reduzimos essa sobrecarga incluindo números apenas a cada décima linha. Isso continua sendo frequente o bastante para que os modelos citem o código corretamente, e a alteração reduziu em 1,6% os tokens de leitura de cache, sem nenhuma perda de qualidade.
Usando subagentes de forma estratégica
Execuções de agente mais longas criam mais oportunidades de delegar trabalho a subagentes. Isso pode reduzir o gasto de tokens porque cada subagente normalmente começa com uma janela de contexto nova, em vez de carregar toda a conversa do agente pai. Assim que ele reporta seus resultados, o agente pai pode seguir em frente sem carregar todo o contexto de trabalho do subagente.
Esse tipo de isolamento de contexto entre agentes e subagentes, porém, tem um custo de coordenação, já que agentes que não compartilham contexto podem duplicar trabalho ou seguir tarefas que já não são necessárias.
Fizemos duas alterações para aproveitar os ganhos de eficiência sem adicionar coordenação desnecessária. Primeiro, removemos as instruções que incentivavam fortemente os agentes a usar subagentes para explorar o codebase. À medida que os subagentes se tornaram mais presentes nos dados de treinamento e os pesquisadores passaram a incorporá-los ao pós-treinamento, os modelos aprenderam esse padrão nativamente. Remover esse prompting extra resultou em um uso mais equilibrado de subagentes.
Também refinamos a forma como os subagentes selecionam modelos. O Cursor pode criar subagentes usando qualquer um dos nossos modelos disponíveis, o que torna possível cobrir pontos cegos entre modelos ou combinar um modelo de planejamento caro com um mais barato para a implementação. Atualizamos os argumentos da ferramenta para que os agentes escolham um modelo diferente apenas quando orientados pelo usuário ou pelo harness.
Continuamos aprimorando a eficiência do harness
Vamos seguir medindo como o contexto se acumula em execuções mais longas e testando em que pontos o harness pode reduzir o processamento repetido sem afetar a qualidade do agente. Com o tempo, esperamos que isso faça o uso de tokens crescer bem mais devagar do que a quantidade de trabalho que os agentes conseguem concluir. Também levamos esses aprendizados ao Grok Bot, onde estamos trabalhando para otimizar seu harness exclusivo, de modo que os usuários consigam realizar o máximo de trabalho ao menor custo.


