Une meilleure efficacité des tokens pour des exécutions d’agent plus longues


À mesure que les agents ont gagné en maturité et appris à s'attaquer à des tâches plus ambitieuses, la consommation de tokens a évolué. Les agents travaillent désormais plus longtemps et conservent davantage de contexte d'une étape à l'autre, ce qui rend la manière dont nous assemblons et gérons ce contexte de plus en plus déterminante.
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
Remarques : les définitions système et d'outils incluent les résumés de compactage. Le texte utilisateur inclut les skills attachés manuellement. Les skills et plugins incluent les descriptions de skills, les descriptions d'outils MCP et les rules qui entrent dans le contexte statique.
Ces derniers mois, nous avons répondu à cette évolution en améliorant l'efficacité du harness d'agents de Cursor. Celle-ci nous donne un contrôle direct sur la façon dont chaque requête est assemblée, dont le contexte est réutilisé et sur le moment où le travail est réparti entre plusieurs agents. Les changements apportés à chacune de ces couches ont réduit de 7 % les coûts en tokens pour les utilisateurs, sans dégrader la qualité de l'agent.
Alléger la requête système
Chaque tour d'agent inclut du contexte fourni par Cursor avant que le modèle ne commence à travailler, à savoir la requête système et les définitions des outils que l'agent peut utiliser. Comme ce contexte est présent tout au long d'une conversation, il était devenu l'une des plus grosses sources de dépenses que nous maîtrisons entièrement.
Lorsque les modèles étaient moins performants, nous devions détailler les instructions concernant l'utilisation des outils, la gestion des tâches et les workflows de modification du code. Il fallait aussi se prémunir contre des comportements étranges comme des dumps de hash interminables, des sorties binaires ou des emojis.
À mesure que les modèles se sont améliorés, une grande partie de ces consignes est devenue superflue. Au lieu de longues listes d'instructions du type « NE PAS faire ceci », « Vous devez » ou « Important », il nous suffisait de définir le comportement d'un outil pour que les modèles s'y conforment dans la plupart des cas. Cela valait pour toutes les familles de modèles, ce qui nous a permis d'alléger notre requête système d'environ 66 %.
Au fil du temps, nous continuons d'ajouter et de supprimer des instructions à mesure que de nouveaux modèles nécessitent un nouvel accompagnement, lequel alimente ensuite l'entraînement des modèles à venir. S'appuyer sur des tests A/B menés auprès d'une large base d'utilisateurs est essentiel pour optimiser efficacement le harness face au trafic réel. Si les évaluations constituent un indicateur rapide et utile, elles portent souvent sur des problèmes « difficiles » et ne reflètent pas fidèlement la véritable distribution des requêtes utilisateur.
Charger les outils uniquement lorsque c'est nécessaire
La requête système ne représente qu'une partie du contexte que Cursor fournit à chaque tour. Les définitions d'outils en constituent une autre, et elles se sont considérablement étoffées au fil de l'année, à mesure que nous ajoutions des capacités plus puissantes à l'agent Cursor : surveillance du shell en arrière-plan, sous-agents cloud, accès plus fiable au contenu web, etc. La plupart de ces outils sont importants, mais chacun d'eux n'est nécessaire que dans moins de 20 % des conversations.
D'où une occasion d'améliorer l'efficacité : garder les outils disponibles sans inclure leurs définitions complètes dans chaque requête. Nous avions résolu un problème similaire plus tôt cette année, en déplaçant les outils MCP vers le contexte dynamique pour ne les charger qu'en cas de besoin. Résultat : une réduction de 46,9 % du nombre total de tokens sur les sessions ayant fait appel à un outil MCP.
Nous avons désormais appliqué la même technique à nos propres outils intégrés.
Pour déterminer quels outils conserver dans le contexte statique, nous avons réalisé des tests A/B sur plusieurs configurations, en nous appuyant sur la fréquence d'utilisation de chaque outil et sur la nécessité pour les modèles de le voir dès le départ. Nous avons suivi l'utilisation de tokens, le coût, la latence, les erreurs d'appel d'outil et l'utilisation globale de l'agent afin de nous assurer que ces économies ne dégradaient pas la qualité.
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
Au final, nous avons conservé dans le contexte statique les outils les plus sollicités : lecture, recherche, édition et utilisation du shell. Nous avons également gardé ask_question, dont certains modèles avaient tendance à halluciner les appels, ainsi que les outils essentiels à des flux produit spécifiques, comme create_plan en Plan Mode. Les outils restants se chargent désormais lorsque l'agent en a besoin.
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
Améliorer la réutilisation du cache
Après avoir réduit la quantité de contexte statique dans chaque requête, nous avons amélioré l'efficacité avec laquelle le contexte répété peut être mis en cache d'un tour à l'autre.
Chaque tour d’agent renvoie une longue requête contenant les outils, les instructions système, l'installation et la conversation jusqu'à ce point. L'essentiel du début reste identique d'un tour d’agent à l'autre, tandis que la conversation, à la fin, ne cesse de s'allonger.
La mise en cache des requêtes permet au provider du modèle de réutiliser ce préfixe inchangé. Les possibilités de configuration de la mise en cache varient toutefois d'un provider à l'autre. Avant GPT-5.6, le périmètre du cache était déterminé automatiquement à partir de la dernière requête. Même si les outils et les instructions système changeaient rarement, ils n'étaient pas clairement identifiés comme réutilisables à eux seuls.
Depuis GPT-5.6, l'API OpenAI permet aux clients de définir des seuils de cache explicites, en complément de sa mise en cache implicite par défaut. Nous plaçons désormais ces seuils après les couches stables de la requête et avant la conversation qui s'allonge, ce qui permet aux tours d’agent suivants de réutiliser une plus grande partie du préfixe inchangé.
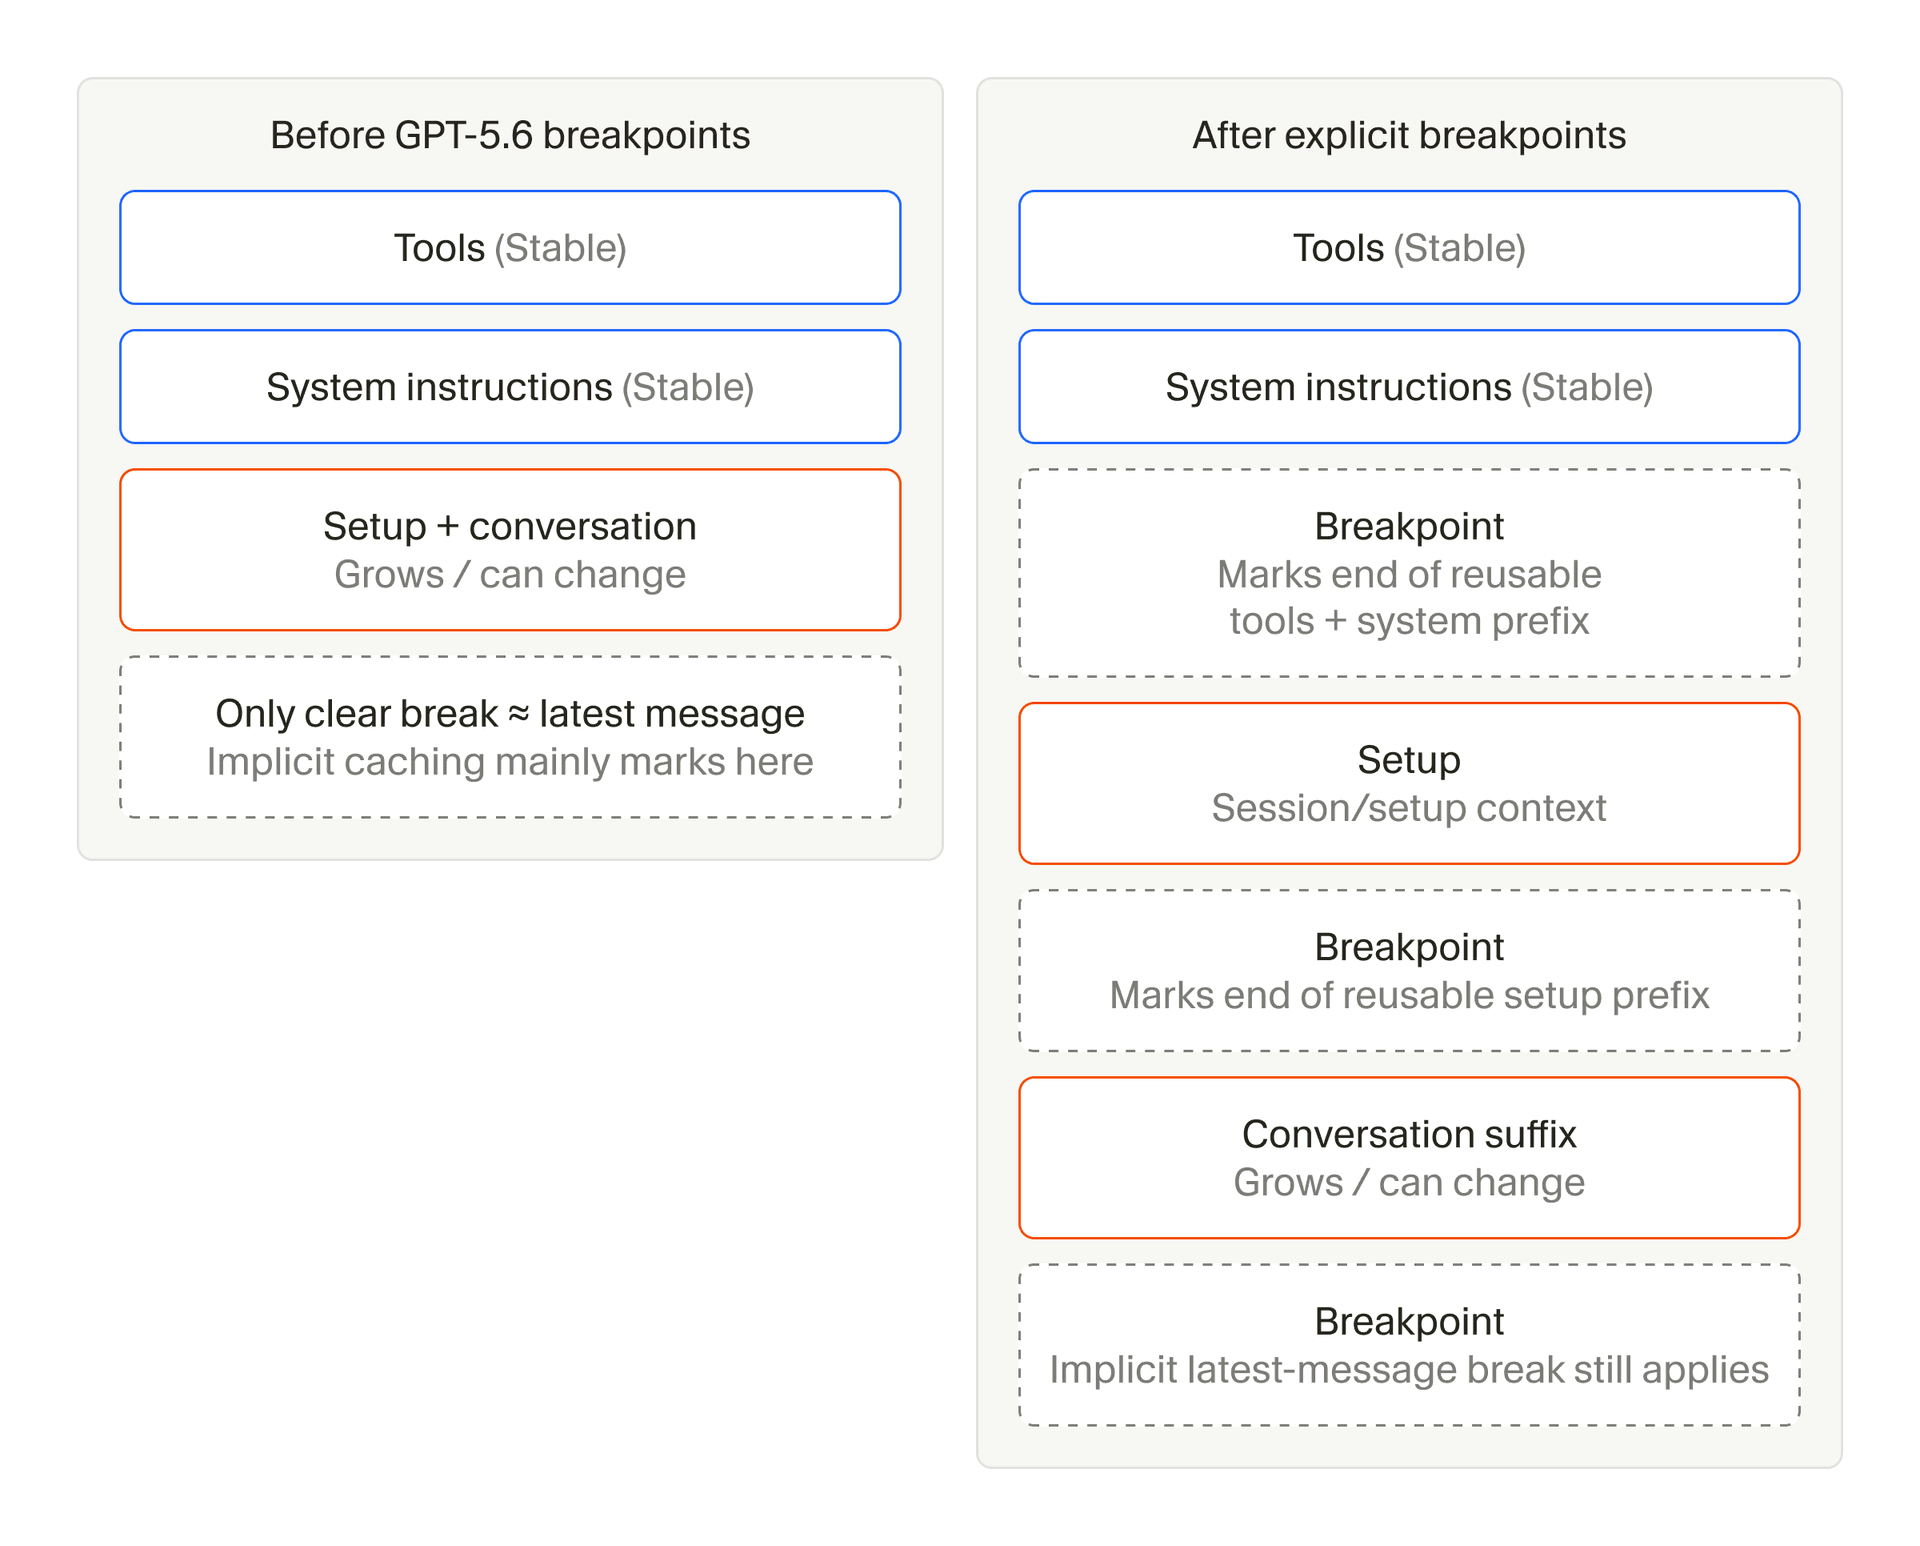
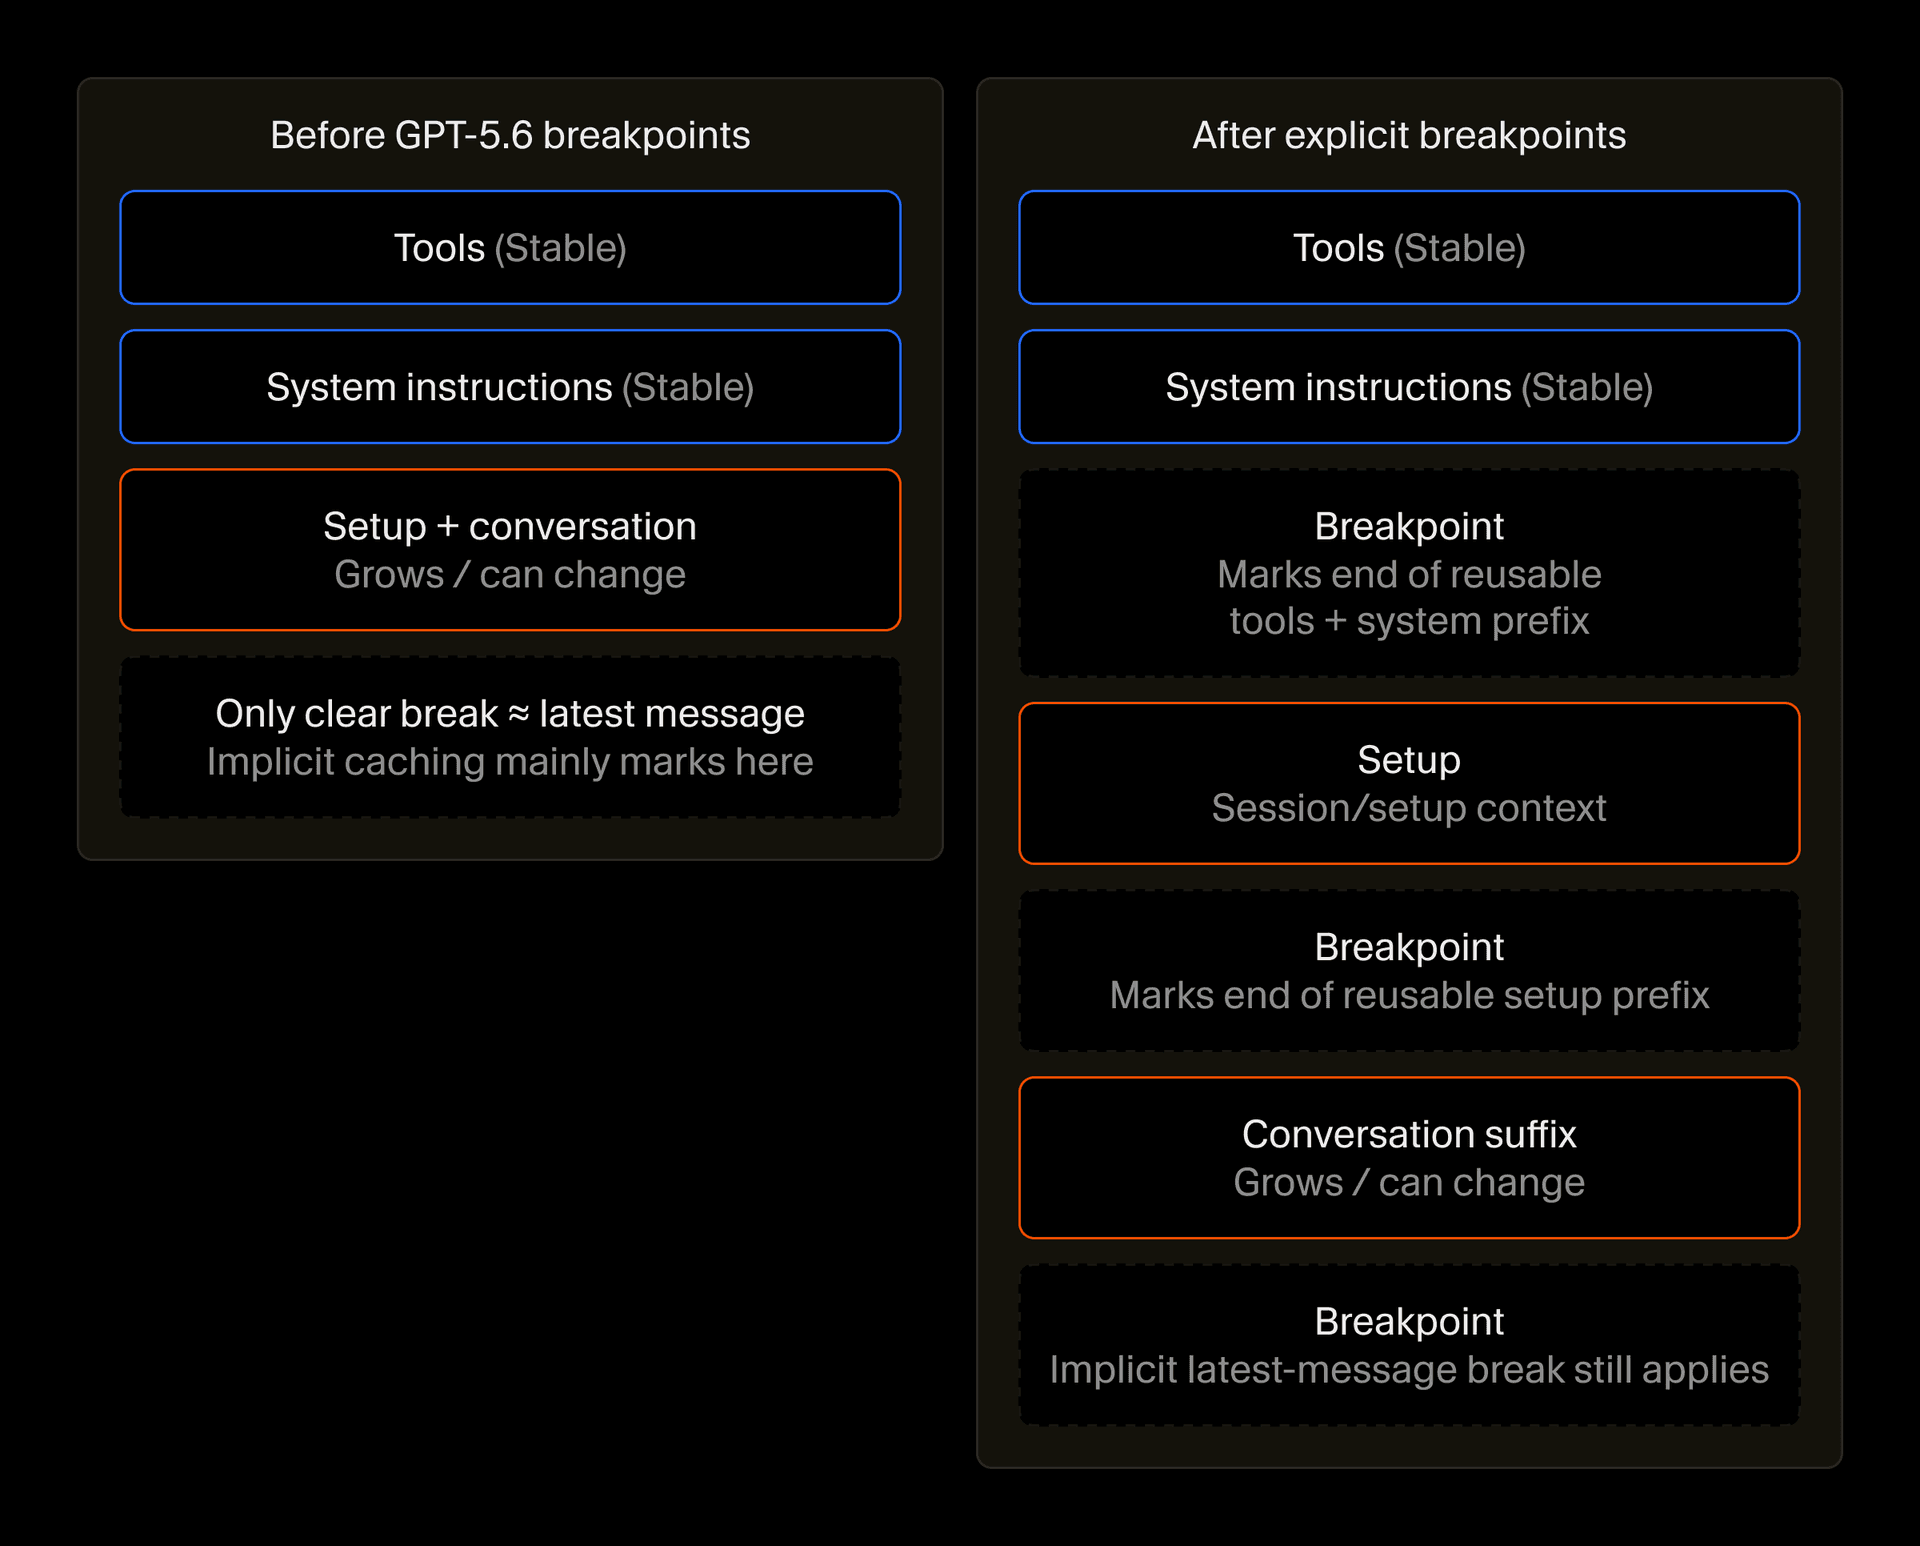
Les seuils de cache ne sont utiles que si le préfixe lui-même reste stable : nous avons donc aussi resserré ce qui figure en tête de chaque requête. Pour cela, nous avons réservé les outils et les instructions système au contenu qui change rarement, et déplacé les éléments d'installation les plus variables au-delà des limites du cache, dans notre « message utilisateur fantôme ». Celui-ci regroupe le contexte propre à l'utilisateur et à la requête : skills, sous-agents et informations d'environnement.
Ces changements ont réduit de 20 % le taux de défauts de cache à froid.
Compresser les lectures de fichiers
Une autre source importante de consommation de tokens est le contexte qu'un agent ajoute au fil de son travail, et qui provient en grande partie de la lecture des fichiers.
L'agent de Cursor lit les fichiers via un outil Read, qui numérotait traditionnellement chaque ligne, car les modèles comptent mal les lignes par eux-mêmes et doivent citer des sections précises à l'utilisateur.
Un numéro de ligne ne consomme qu'environ trois à cinq tokens, mais lorsqu'un agent lit des dizaines de milliers de lignes au cours d'une session, les numéroter toutes finit par ajouter une quantité de contexte non négligeable.
Nous avons réduit cette surcharge en n'affichant les numéros qu'une ligne sur dix. Cela reste suffisamment fréquent pour que les modèles citent correctement le code, et ce changement a réduit les tokens de lecture en cache de 1,6 % sans aucune baisse de qualité.
Utiliser les sous-agents de façon stratégique
Plus les exécutions d'agent sont longues, plus les occasions de déléguer du travail à des sous-agents se multiplient. Cela peut réduire la consommation de tokens, car chaque sous-agent démarre généralement avec une context window vierge plutôt que de reprendre l'intégralité de la conversation de l'agent parent. Une fois ses résultats transmis, le parent peut poursuivre sans avoir à traîner tout le contexte de travail du sous-agent.
Ce type d'isolation du contexte entre agents et sous-agents a toutefois un coût de coordination : des agents qui ne partagent pas de contexte peuvent faire le travail en double ou poursuivre des tâches devenues inutiles.
Nous avons apporté deux changements pour tirer parti des gains d'efficacité sans ajouter de coordination superflue. D'abord, nous avons supprimé les instructions qui encourageaient fortement les agents à recourir à des sous-agents pour l'exploration de la base de code. À mesure que les sous-agents ont gagné en présence dans les données d'entraînement et que les chercheurs les ont intégrés au post-entraînement, les modèles ont appris ce pattern nativement. Retirer ces requêtes supplémentaires a donné lieu à une utilisation plus équilibrée des sous-agents.
Nous avons aussi resserré la façon dont les sous-agents sélectionnent les modèles. Cursor peut lancer des sous-agents avec n'importe lequel de nos modèles disponibles, ce qui permet de compenser les angles morts d'un modèle à l'autre ou d'associer un modèle de planification coûteux à un modèle moins cher pour l'implémentation. Nous avons mis à jour les arguments de l'outil afin que les agents ne choisissent un modèle différent que sur indication de l'utilisateur ou du harness.
Continuer d'améliorer l'efficacité du harness
Nous continuerons à mesurer la façon dont le contexte s'accumule sur les exécutions longues et à identifier les cas où le harness peut réduire les traitements redondants sans nuire à la qualité de l'agent. À terme, nous nous attendons à ce que la consommation de tokens progresse bien plus lentement que la quantité de travail que les agents sont capables d'accomplir. Nous avons également transposé ces enseignements au Bot Grok, dont nous cherchons à optimiser le harness spécifique afin que les utilisateurs accomplissent le plus de travail possible au coût le plus faible.


