提升长时间智能体运行的 token 效率


随着智能体日趋成熟、能够胜任更具挑战性的任务,token 支出的格局也随之改变。如今智能体运行时间更长,并会将更多上下文从一个步骤延续到下一个步骤,这让我们组织和管理上下文的方式变得愈发重要。
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
说明:系统与工具定义包含 compaction 摘要。用户文本包含手动附加的技能。技能与插件包含技能描述、MCP 工具描述,以及纳入静态上下文的规则。
过去几个月,我们针对这一转变,着力提升了 Cursor 智能体 harness 的效率。harness 让我们可以直接掌控每个请求如何组装、上下文如何复用,以及何时把工作拆分给多个智能体。这几个层面的改动共同将用户的 token 成本降低了 7%,而智能体质量并未下降。
精简系统提示
在模型开始工作之前,Cursor 会为智能体的每一轮 (turn) 提供上下文,其中包括系统提示以及智能体可用工具的定义。由于这部分上下文会贯穿整个对话,它已成为我们能够完全掌控的最大支出来源之一。
在模型能力还较弱时,我们必须把工具使用、任务管理和代码修改工作流的指令写得事无巨细,还要防范一些古怪的行为,比如输出超长的 hash 转储、二进制内容和表情符号。
随着模型能力提升,其中大部分指引已不再必要。我们无需再罗列一长串「不要做某事」「您必须」或「重要」之类的指令,只需定义工具的行为方式,模型通常就会照做。这一点在各个模型家族中都成立,使我们得以精简掉约 66% 的系统提示。
随着时间推移,新模型需要新的指引,我们也会持续增删指令,而这些指引又会融入未来模型的训练之中。要针对真实流量有效优化 harness,在大规模用户群体上开展 A/B 测试至关重要。evals 虽然是一种快速且实用的替代手段,但它们往往代表的是「困难」问题,无法真实反映用户请求的实际分布。
仅在需要时加载工具
系统提示只是 Cursor 在每一轮对话中提供的上下文的一部分,另一部分是工具定义。随着这一年里我们为 Cursor 智能体添加了越来越强大的功能——包括后台 shell 监控、云端子智能体以及更可靠的网页内容访问——工具定义的规模急剧膨胀。这些工具大多很重要,但每个工具真正用得上的对话都不到 20%。
这就带来了一个提升效率的机会:让工具保持可用,但不必在每个请求中都附带其完整定义。今年早些时候我们解决过类似的问题——把 MCP 工具移入动态上下文,仅在需要时加载。这让调用过 MCP 工具的会话总 token 数减少了 46.9%。
如今,我们把同样的思路应用到了自己的内置工具上。
为了确定哪些工具应保留在静态上下文中,我们依据每个工具的使用频率以及模型是否需要从一开始就看到它,对多种配置进行了 A/B 测试。我们跟踪了 token 用量、成本、延迟、工具调用错误信息以及整体智能体用量,以确保节省开销不会牺牲质量。
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
最终,我们将读取、搜索、编辑和使用 shell 这几类高频工具保留在静态上下文中;同时保留了 ask_question (部分模型容易幻觉出对它的调用) ,以及对特定产品流程至关重要的工具,比如规划模式中的 create_plan。其余工具现在只在智能体需要时才加载。
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
提升缓存复用率
在减少每个请求中静态上下文的数量之后,我们进一步提升了重复上下文跨轮次缓存的效率。
智能体的每一轮都会重新发送一个很长的请求,其中包含工具、系统指令、设置以及此前的对话内容。请求开头的大部分内容在各轮之间保持不变,而结尾的对话却在不断变长。
提示缓存让模型提供方得以复用这段未变化的前缀。不过,缓存的可配置程度因提供方而异。在 GPT-5.6 之前,缓存边界由系统根据最新请求自动确定;尽管工具和系统指令很少变动,它们本身却没有被明确标记为可复用。
从 GPT-5.6 开始,OpenAI API 允许客户端在默认的隐式缓存之外显式标记缓存断点。现在,我们会把断点放在请求中稳定部分之后、不断增长的对话之前,让后续轮次能够复用更多未变化的前缀。
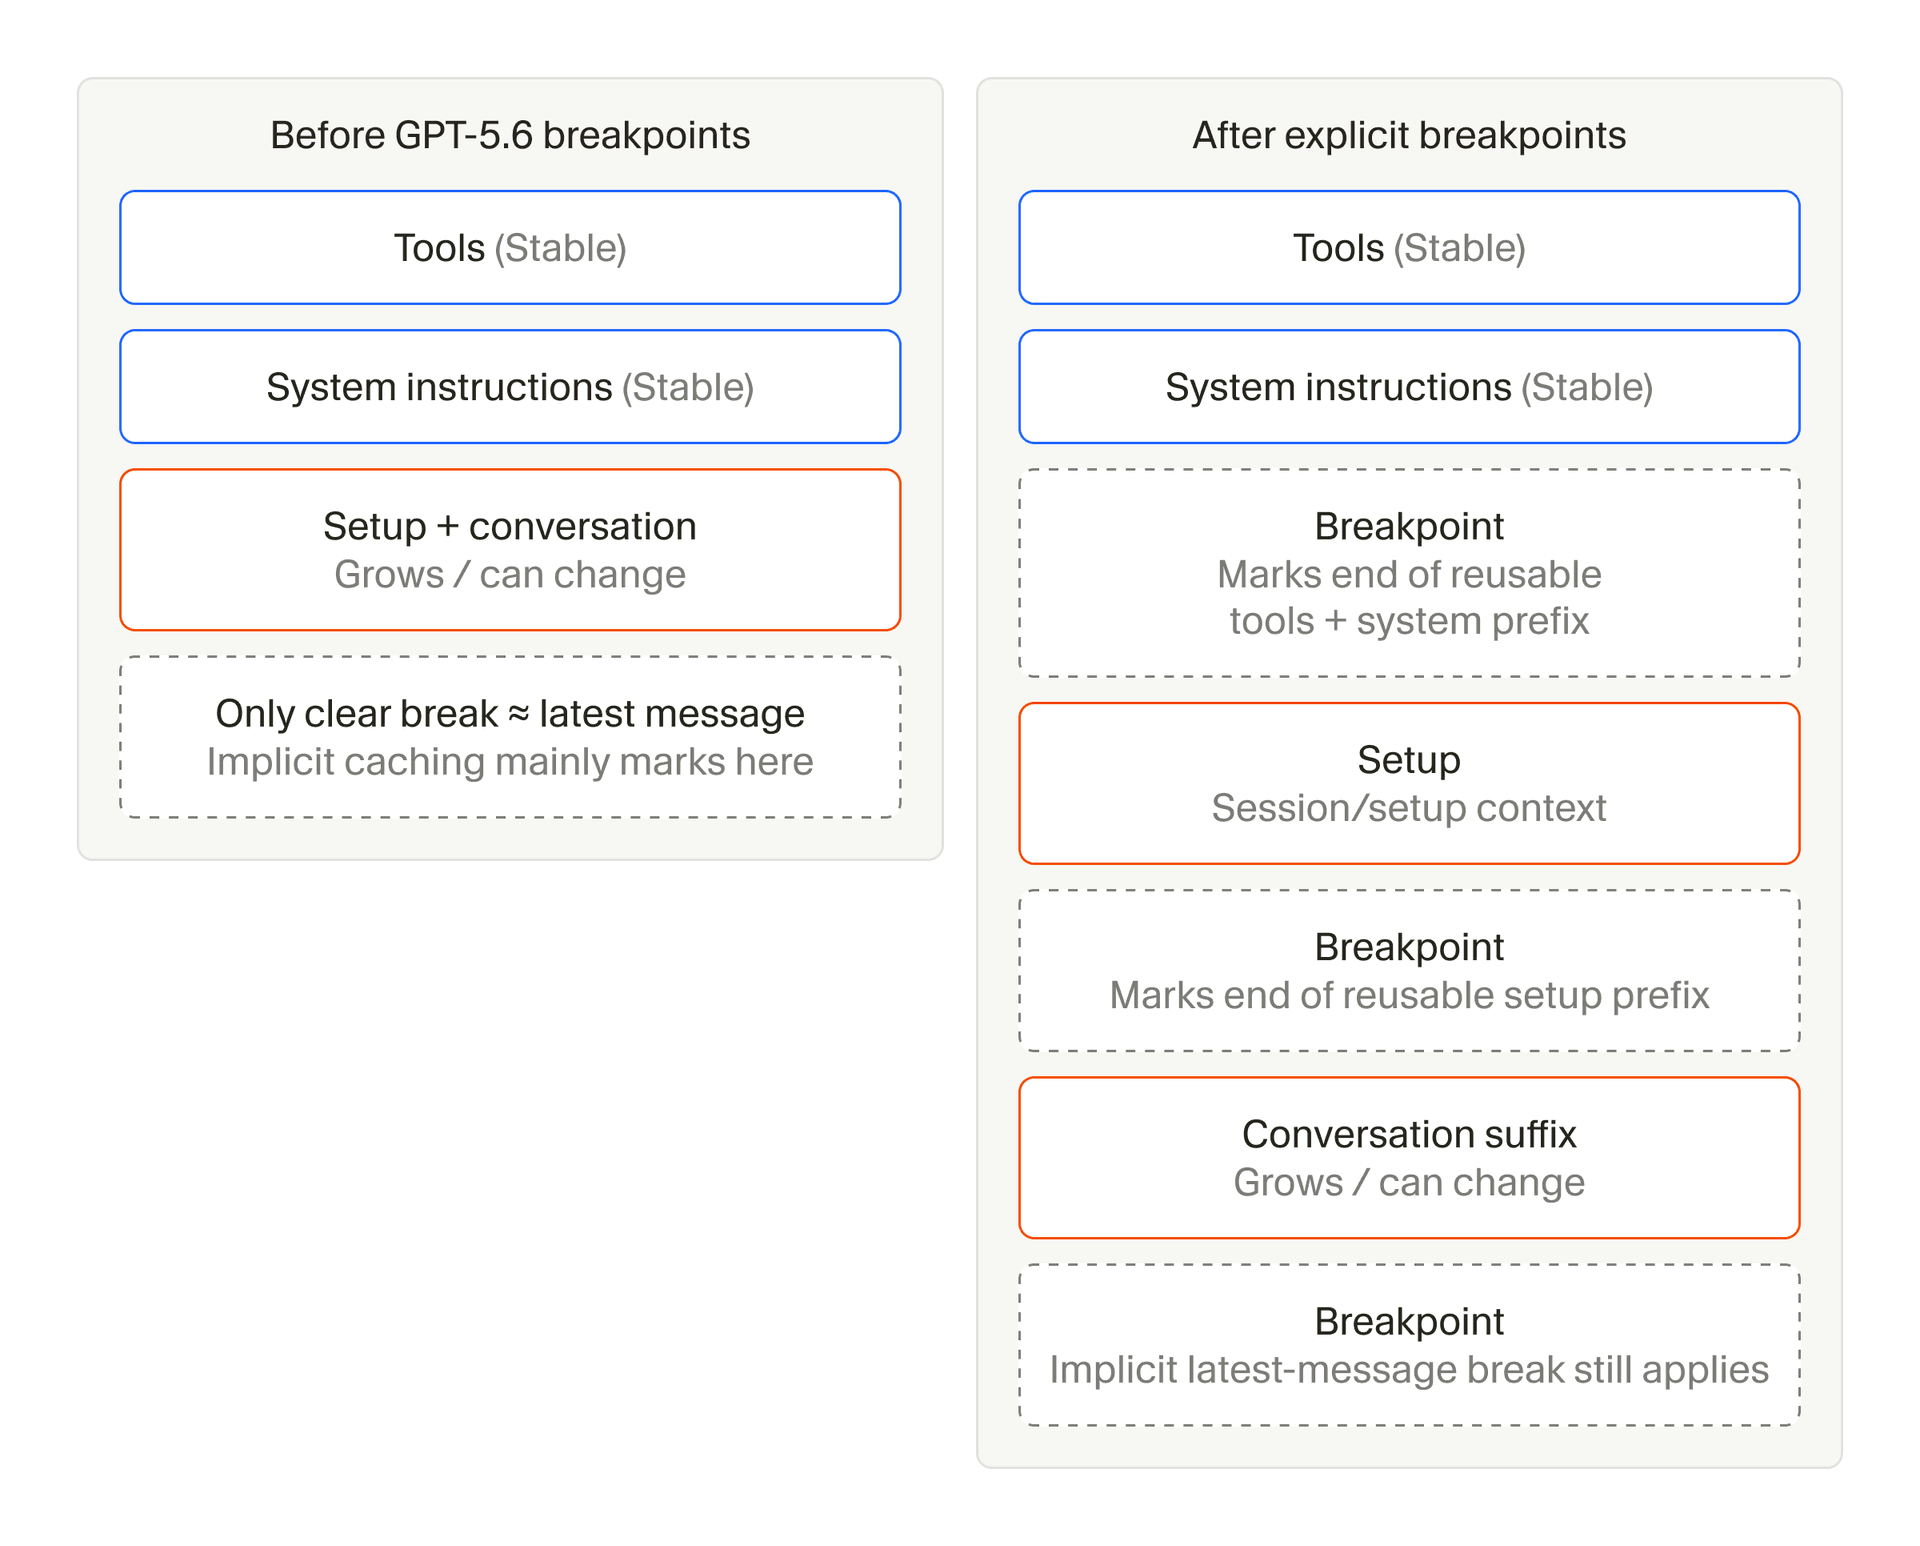
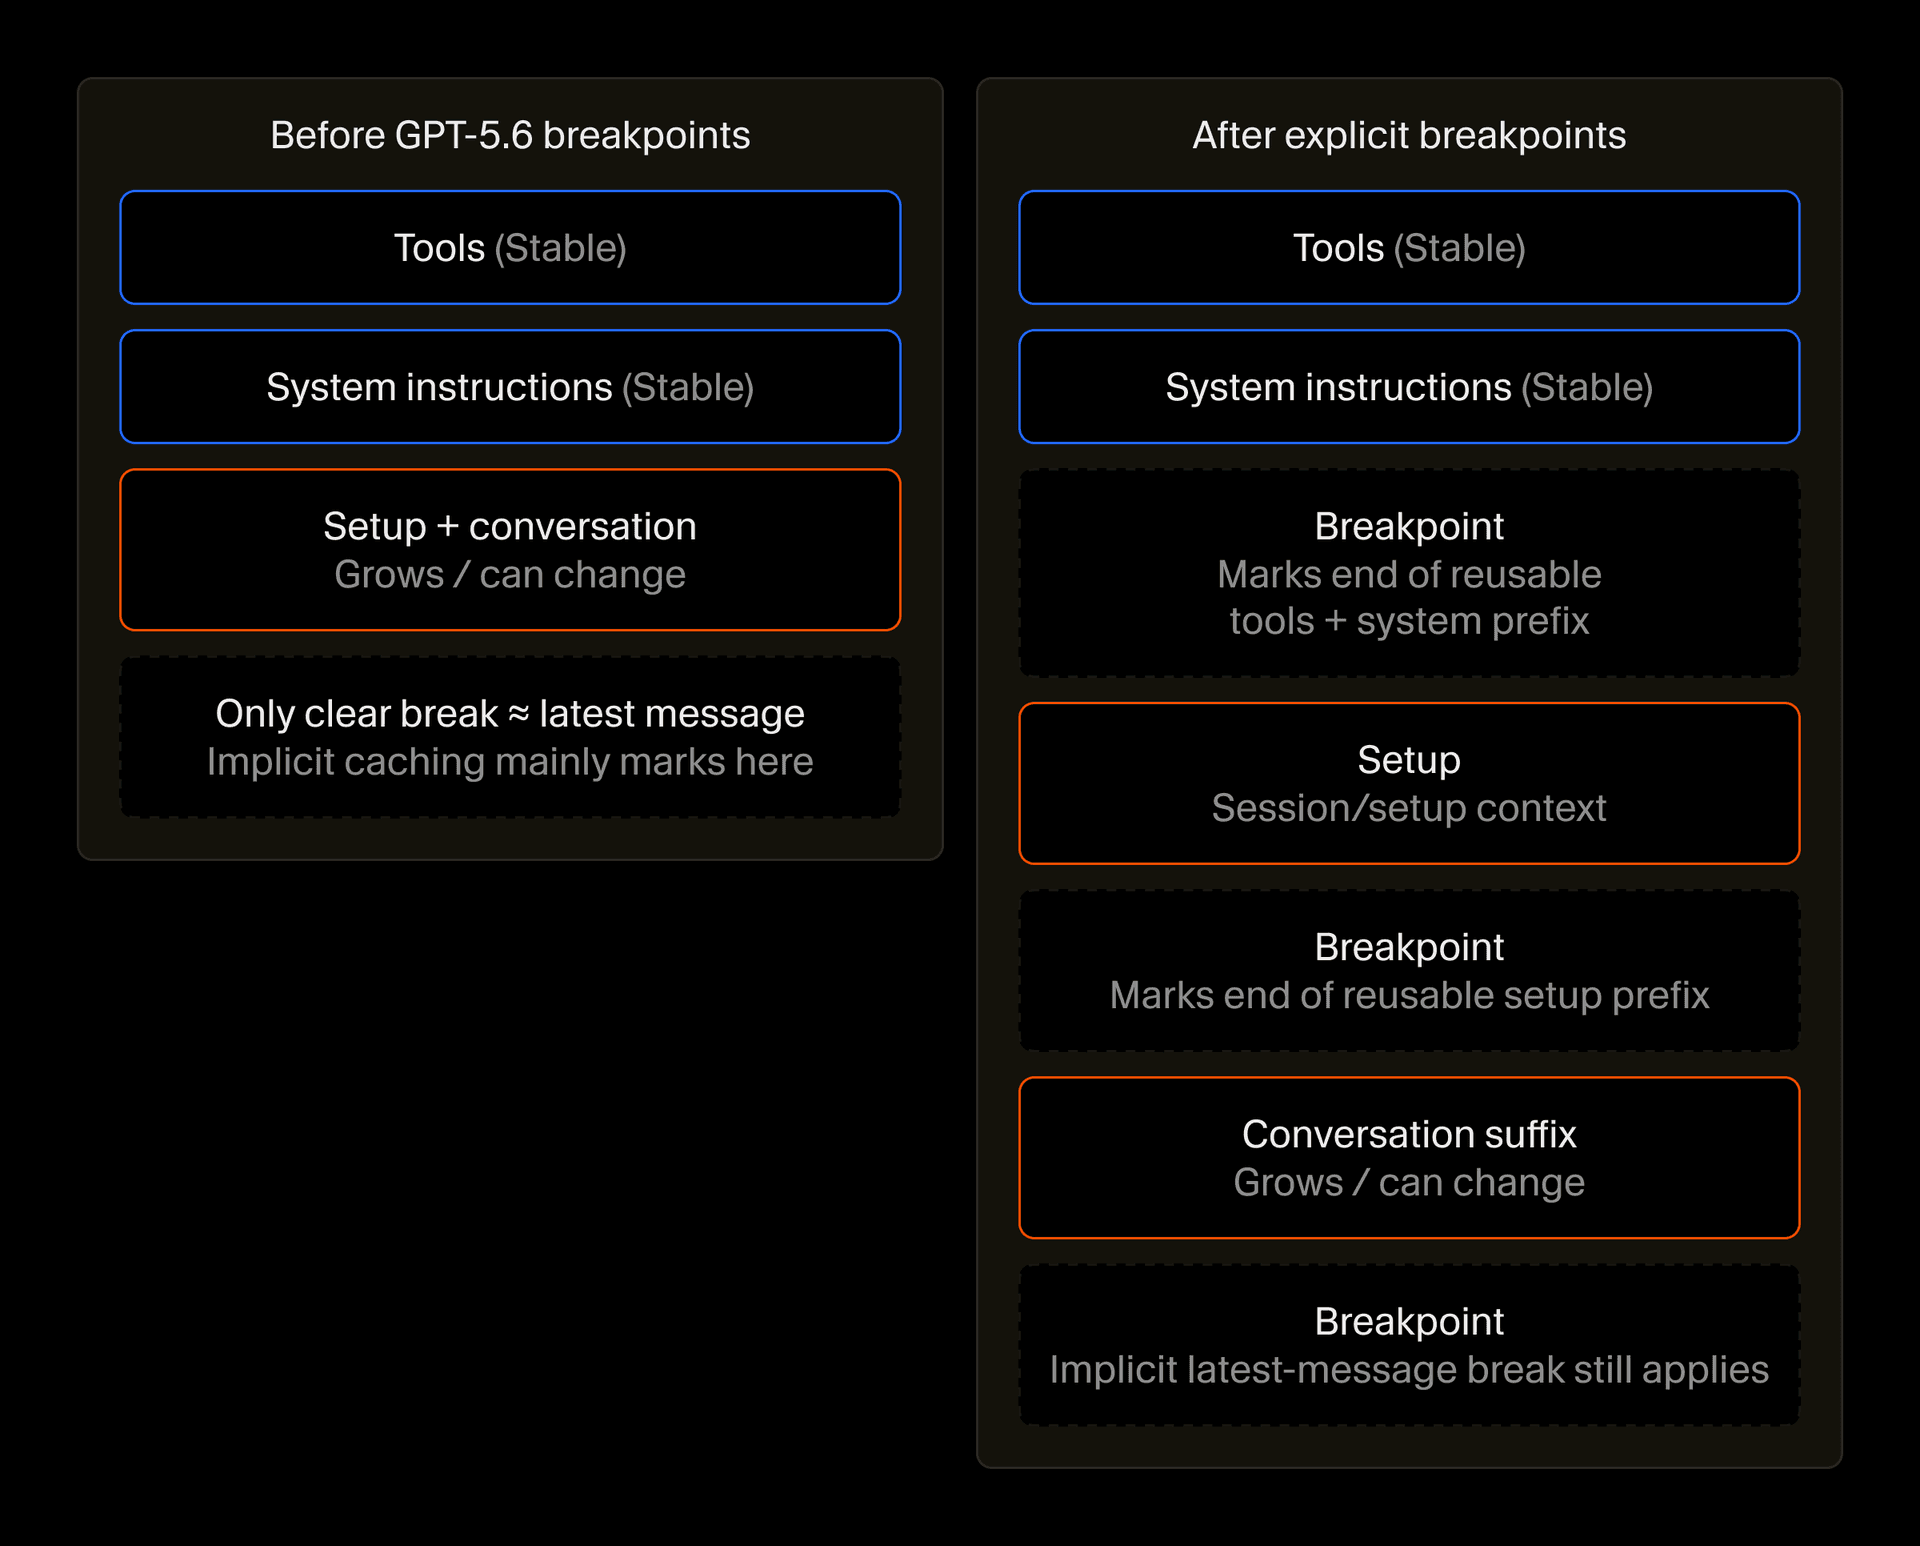
只有前缀本身保持稳定,断点才能发挥作用,因此我们也精简了每个请求最前面的内容。具体做法是:工具和系统指令只保留极少变动的内容,并把更多可变的设置移到缓存边界之后的"幻影用户消息"中,用它来承载用户级和请求级的上下文,比如技能、子智能体和环境信息。
这些改动使冷缓存未命中率降低了 20%。
压缩文件读取
token 支出的另一大来源,是智能体在工作过程中不断添加的上下文,其中很大一部分来自读取文件。
Cursor 的智能体通过 Read 工具读取文件,该工具以往会为每一行都标上行号,因为模型自己并不擅长数行数,而又需要向用户引用具体的代码片段。
一个行号只占约三到五个 token,但当智能体在一次会话中读取数万行代码时,逐行编号累积起来就是相当可观的上下文。
为此,我们改为每十行才标注一次行号,以降低这部分开销。这个频率仍足以让模型准确引用代码,而这一改动使缓存读取的 token 减少了 1.6%,质量则毫无下降。
策略性地使用子智能体
智能体运行的时间越长,可委派给子智能体的工作机会就越多。这能降低 token 支出,因为每个子智能体通常从全新的上下文窗口开始,而不会带上父智能体的完整对话。子智能体汇报结果后,父智能体即可继续推进,无需承载子智能体的全部工作上下文。
不过,智能体与子智能体之间的这种上下文隔离确实存在协调成本:不共享上下文的智能体可能重复劳动,或去执行已无必要的任务。
为了在不增加多余协调开销的前提下获得效率收益,我们做了两处改动。首先,我们移除了那些强烈鼓励智能体调用子智能体进行代码库探索的指令。随着子智能体在训练数据中愈发常见,研究人员也将其纳入后训练,模型已原生掌握了这一模式。去掉额外的提示后,子智能体的使用变得更加均衡。
我们还收紧了子智能体选择模型的方式。Cursor 可以使用我们任意一个可用模型来生成子智能体,这样既能弥补不同模型之间的盲点,也能让昂贵的规划模型与更廉价的实现模型搭配使用。我们更新了工具参数,使智能体仅在用户或 harness 明确指示时才改用其他模型。
持续提升 harness 效率
我们将继续衡量上下文在长时间运行中的累积情况,并测试 harness 可以在哪些环节减少重复处理而又不影响智能体的质量。随着时间推移,我们预计这将让 token 用量的增长远远慢于智能体完成的工作量。我们也把这些经验用到了 Grok Bot 上,正在优化它独有的 harness,让用户以最低的成本完成最多的工作。


