長時間のエージェント実行に向けたトークン効率の向上


エージェントが成熟し、より意欲的なタスクにも取り組めるようになったことで、トークン消費のあり方も変わってきました。エージェントは以前より長く動作し、あるステップから次のステップへと多くのコンテキストを引き継ぎます。そのため、コンテキストをどう組み立て、管理するかがますます重要になっています。
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
注: システムおよびツール定義には、コンパクションの要約が含まれます。ユーザーテキストには、手動で添付したスキルが含まれます。スキルおよびプラグインには、スキルの説明、MCPツールの説明、静的コンテキストに入るルールが含まれます。
ここ数か月、私たちはこの変化を踏まえ、Cursorのエージェントハーネスの効率化を進めてきました。ハーネスにより、各リクエストをどのように組み立てるか、コンテキストをどう再利用するか、作業をどのタイミングでエージェント間に分割するかを直接制御できます。これらの各レイヤーに加えた変更によって、エージェントの品質を落とすことなく、ユーザーのトークンコストを7%削減しました。
システムプロンプトの削減
エージェントの各ターンには、モデルが作業を始める前にCursorが提供するコンテキストが含まれます。具体的には、システムプロンプトと、エージェントが使えるツールの定義です。このコンテキストは会話の間ずっと含まれ続けるため、私たちが完全に制御できる支出要因の中でも最大級のものになっていました。
モデルの能力がまだ低かった頃は、ツールの使い方、タスク管理、コード変更のワークフローについて、手順を細かく書き下す必要がありました。また、極端に長いハッシュの羅列やバイナリ出力、絵文字といった奇妙な挙動も防がなければなりませんでした。
モデルが進化するにつれ、そうした指示の多くは不要になりました。「〜してはいけない」「必ず〜せよ」「重要」といった指示を延々と並べなくても、ツールがどう振る舞うかを定義するだけで、モデルはおおむねそれに従うようになったのです。これはどのモデルファミリーにも共通していたため、システムプロンプトのおよそ66%を削減できました。
その後も、新しいモデルが新たな指針を必要とするのに応じて指示の追加・削除を続けており、その内容は将来のモデルの学習へと還元されていきます。実際のトラフィックに合わせてハーネスを効果的に最適化するには、大規模なユーザーベースでのA/Bテストの活用が欠かせません。evalは手早く役に立つ代替手段になり得ますが、多くの場合「難しい」問題に偏っており、実際のユーザーリクエストの分布を正しく反映していません。
必要なときだけツールを読み込む
システムプロンプトは、Cursor が毎ターン渡しているコンテキストの一部にすぎません。もう一つがツール定義です。バックグラウンドシェルの監視、クラウドサブエージェント、より信頼性の高いウェブコンテンツへのアクセスなど、Cursor エージェントに強力な機能を追加していく中で、この1年で大幅に膨らみました。これらのツールの多くは重要ですが、実際に必要になるのは会話全体の20%未満です。
ここに、ツールを利用可能なまま維持しつつ、その完全な定義を毎回のリクエストに含めないことで効率を高める余地が生まれました。同様の課題は今年の初めにも解決しています。MCP ツールを動的コンテキストへ移し、必要なときにのみ読み込むようにしたのです。これにより、MCP ツールを呼び出したセッション全体でトータルトークンを46.9%削減できました。
今回、同じ手法を Cursor 自身の組み込みツールにも適用しました。
どのツールを静的コンテキストに残すかを判断するため、各ツールの使用頻度と、モデルが最初から把握しておく必要があるかどうかをもとに、いくつかの構成を A/B テストしました。削減によって品質が損なわれないことを確かめるため、トークン使用量、コスト、レイテンシ、ツール呼び出しのエラー、そしてエージェント全体の使用量を追跡しました。
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
最終的に、読み取り、検索、編集、シェル利用といった高頻度のツールは静的コンテキストに残しました。また、一部のモデルが呼び出しをハルシネーションしがちだった ask_question や、プランモードの create_plan のように特定のプロダクトフローに不可欠なツールも残しています。それ以外のツールは、エージェントが必要としたときに読み込まれるようになりました。
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
キャッシュ再利用の改善
各リクエストに含まれる静的コンテキストの量を削減したうえで、繰り返し登場するコンテキストをターンをまたいでより効果的にキャッシュできるよう改善しました。
エージェントのターンごとに、ツール、システム指示、セットアップ、そしてそれまでの会話を含む長いリクエストを毎回送信しています。先頭部分の多くはターンが変わってもほぼ同じままですが、末尾の会話は増え続けます。
プロンプトキャッシュを使えば、モデルプロバイダーはこの変化しない先頭部分 (プレフィックス) を再利用できます。ただし、キャッシュをどこまで設定できるかはプロバイダーによって異なります。GPT-5.6 以前は、キャッシュの境界は最新のリクエストに基づいて自動的に決定されていました。ツールやシステム指示はほとんど変わらないにもかかわらず、それ自体が再利用可能なものとして明確にマークされることはありませんでした。
GPT-5.6 以降、OpenAI API では既定の暗黙的なキャッシュに加えて、クライアントが明示的なキャッシュのブレークポイントを指定できるようになりました。現在は、リクエストのうち変化の少ない層の直後、かつ増え続ける会話の手前にブレークポイントを配置しており、後続のターンで変化しないプレフィックスをより多く再利用できるようになっています。
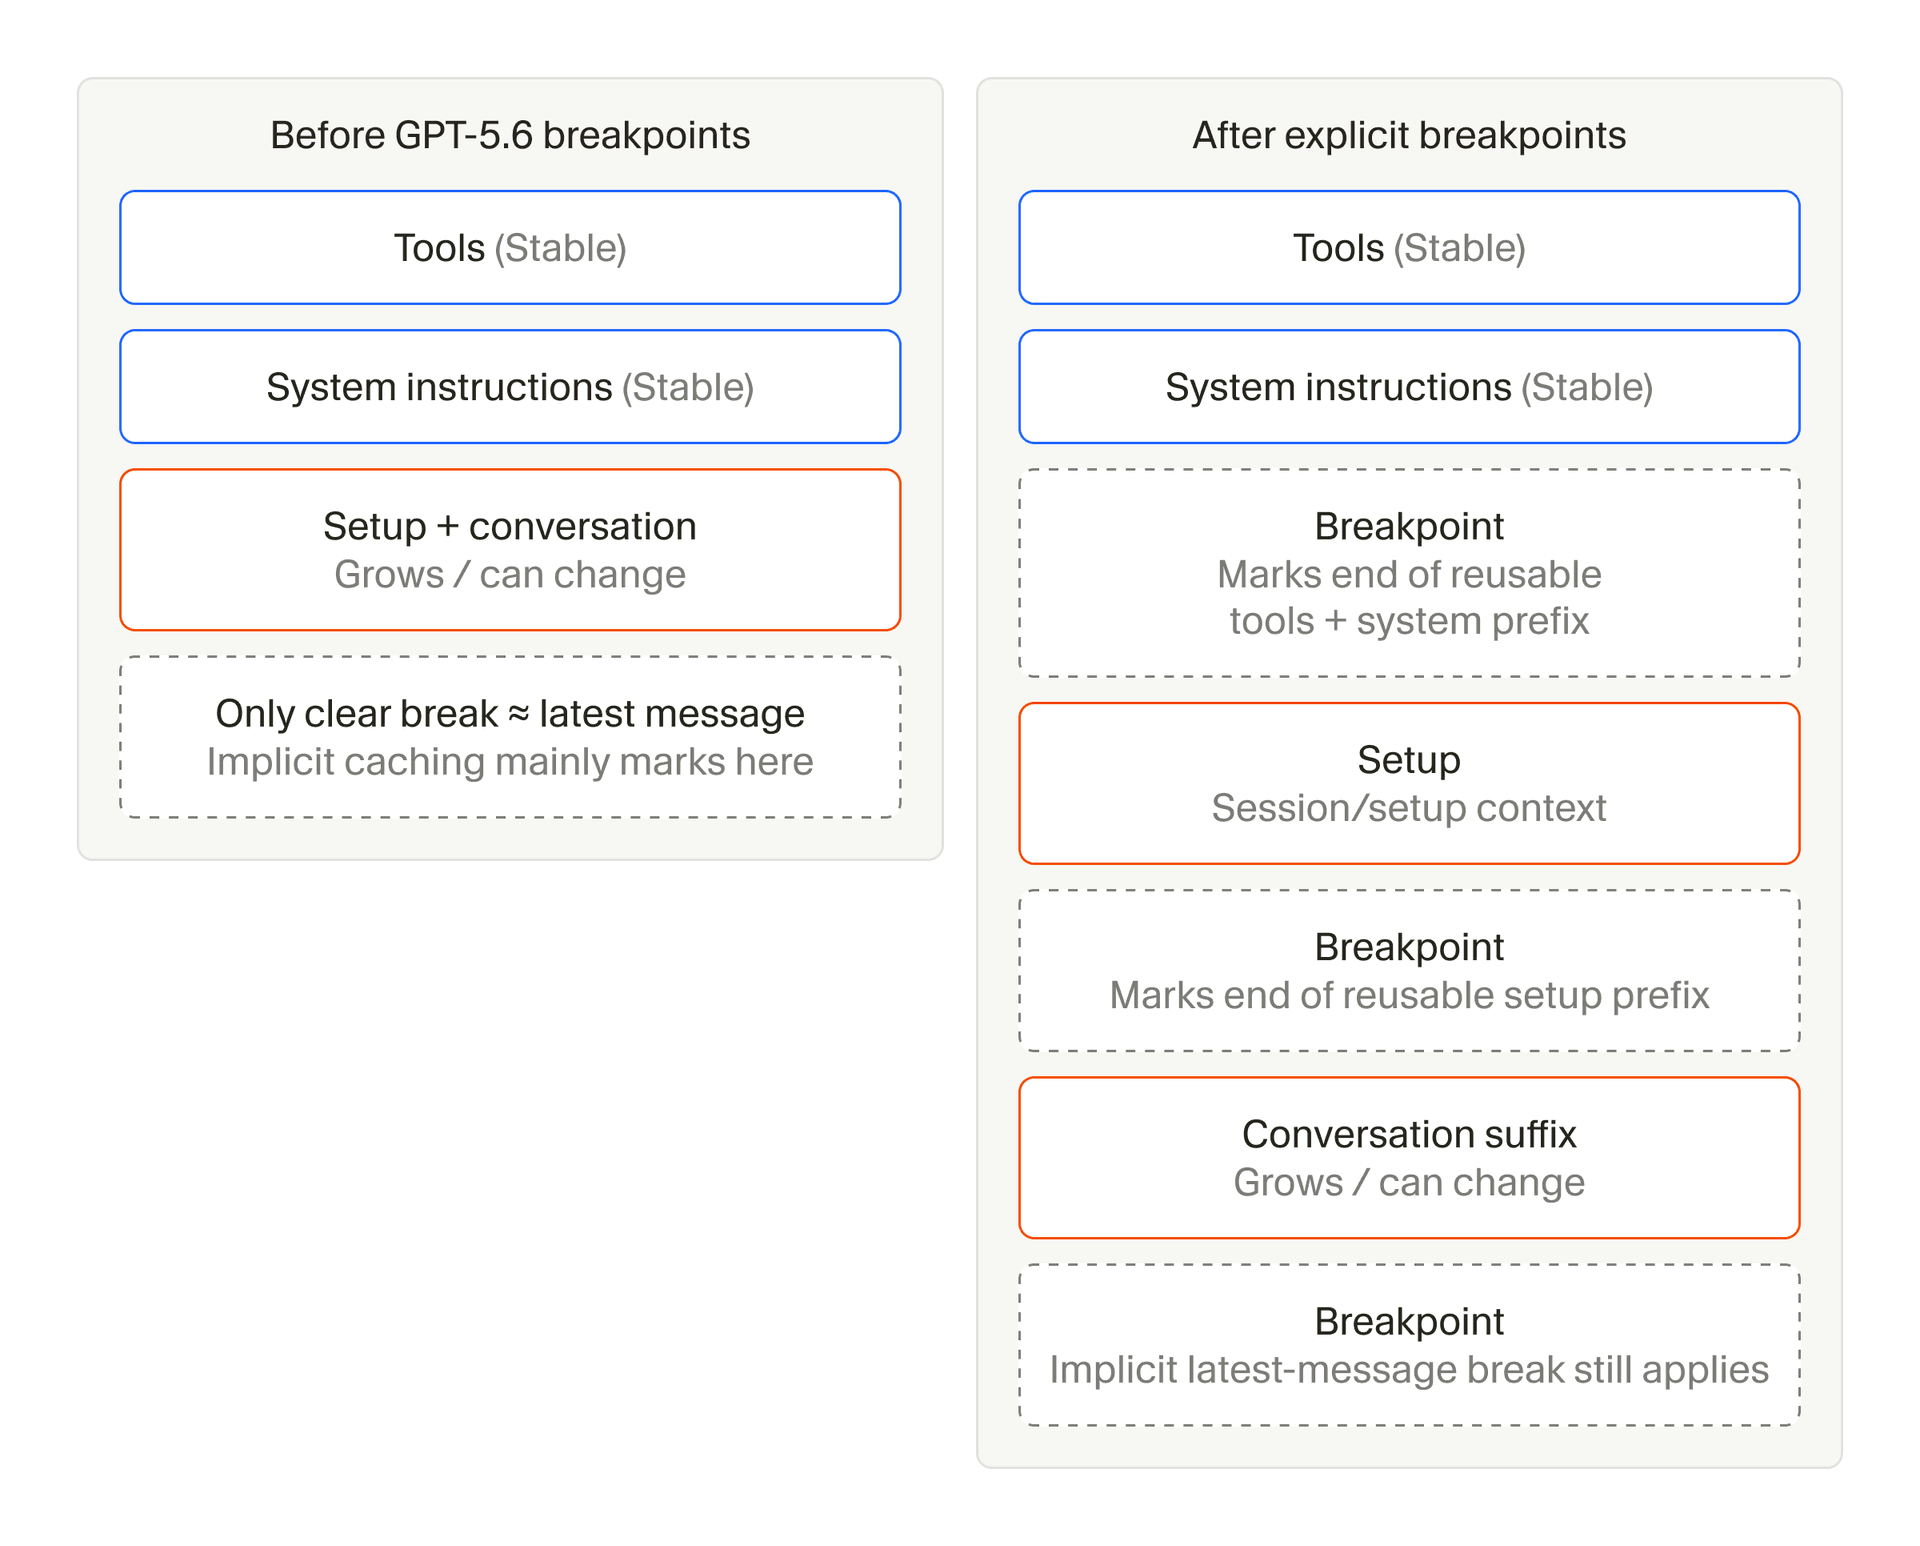
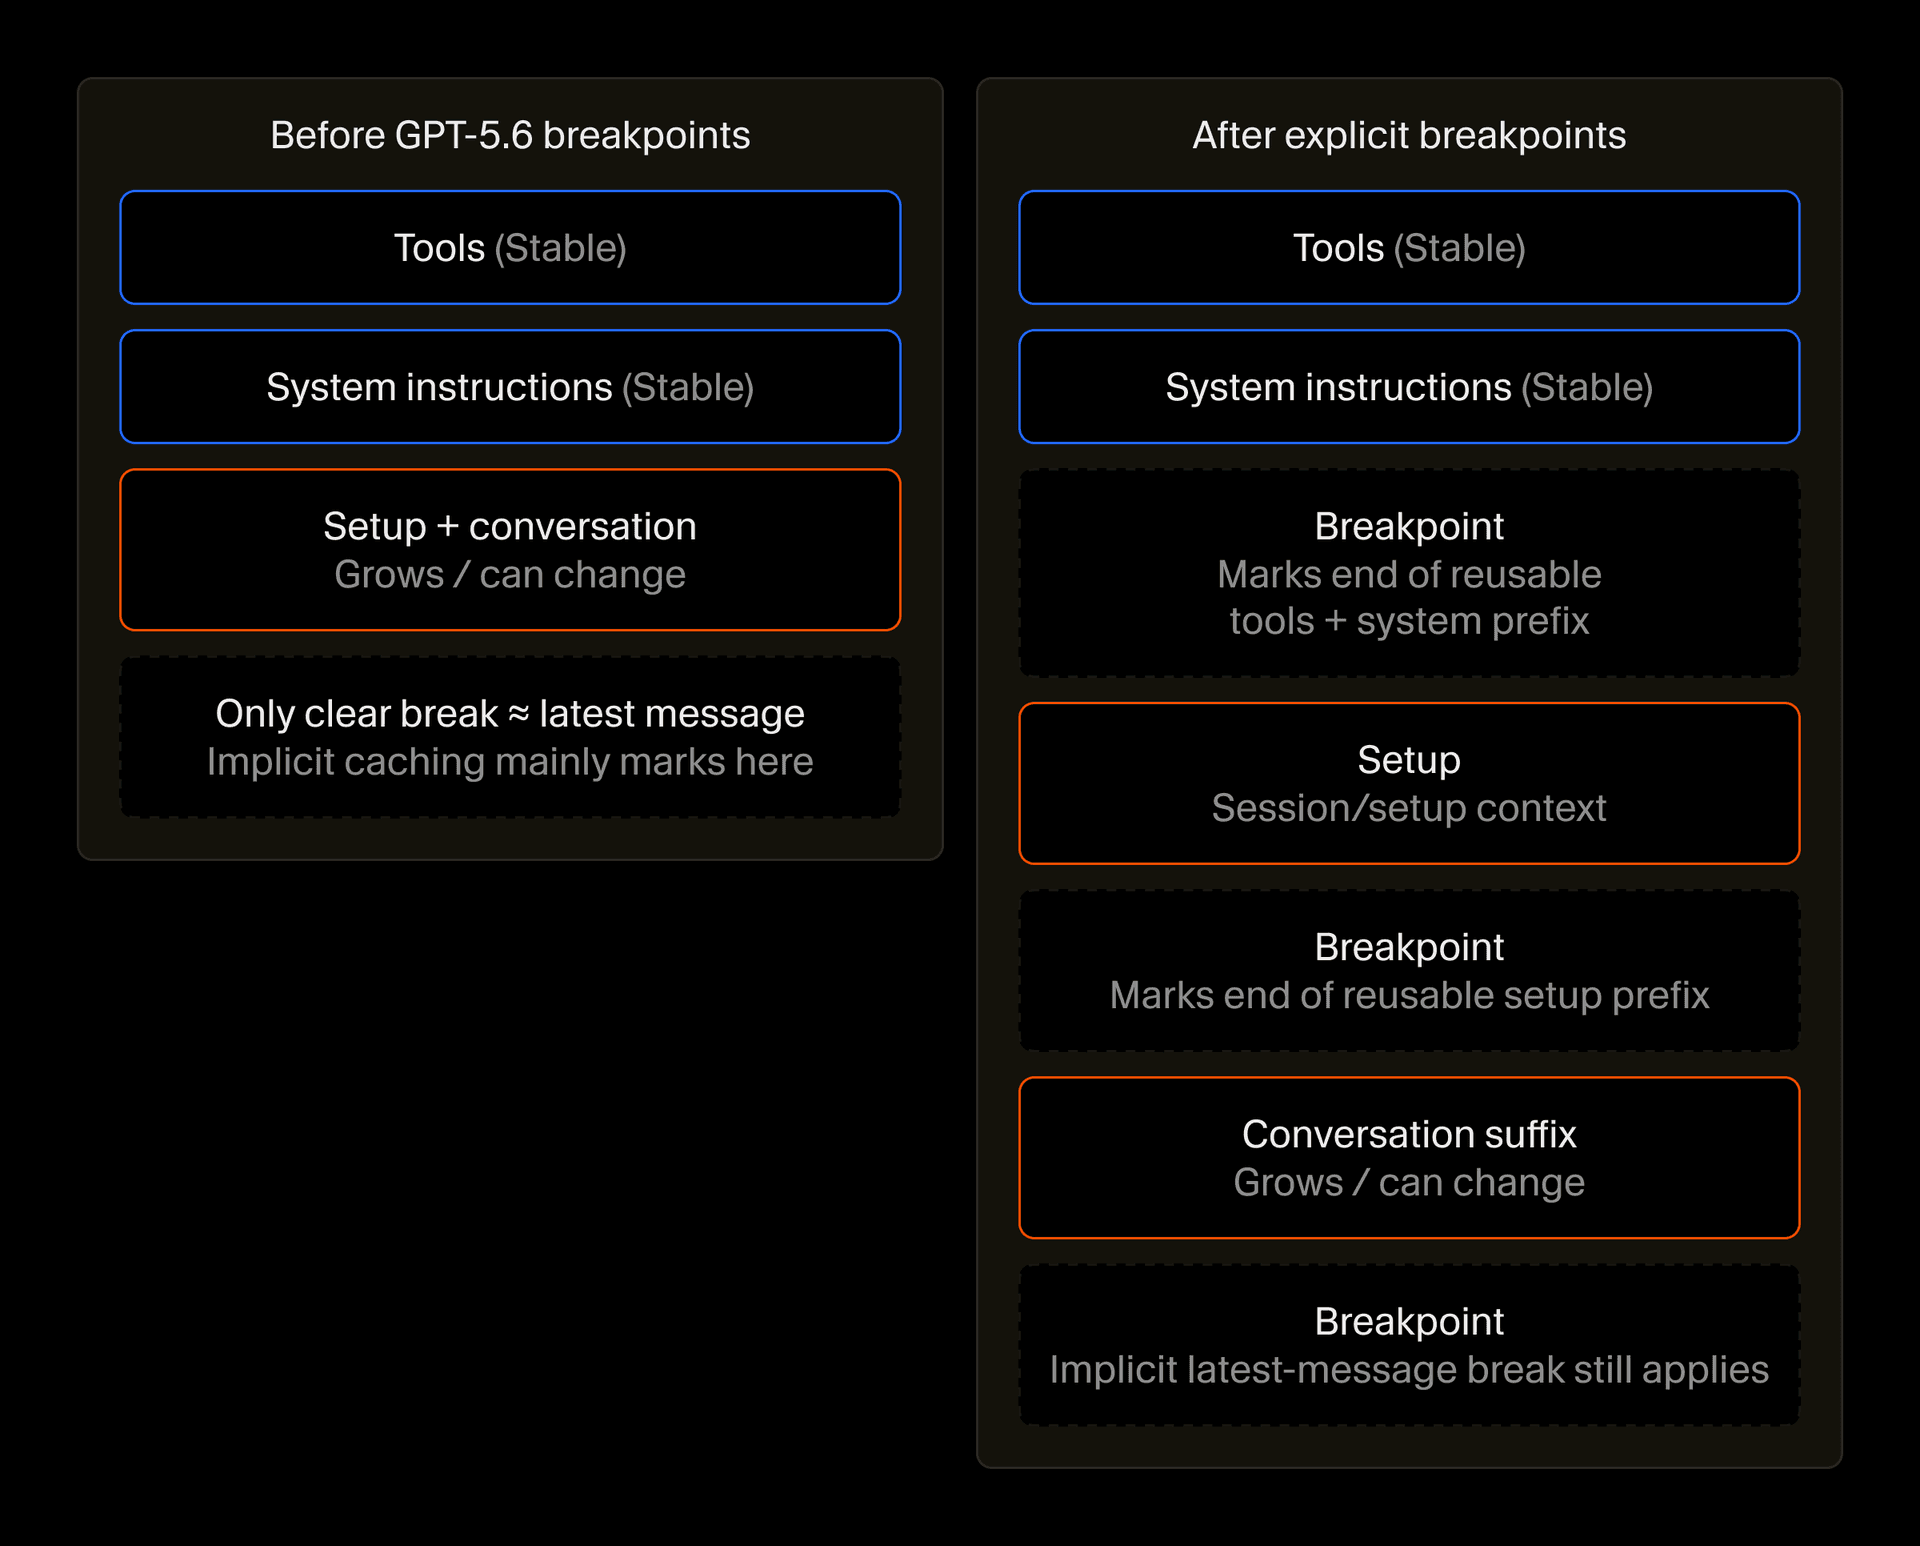
ブレークポイントが効果を発揮するのは、プレフィックス自体が安定している場合だけです。そこで、各リクエストの先頭に置く内容も見直して整理しました。具体的には、ツールとシステムインストラクションはめったに変化しない内容のために確保し、変動しやすい設定はキャッシュ境界の後ろにある"ファントムユーザーメッセージ"へ移しました。ここには、スキル、サブエージェント、環境情報といったユーザー固有・リクエスト固有のコンテキストが入ります。
これらの変更により、コールドキャッシュミスの発生率を20%削減しました。
ファイル読み取りの圧縮
トークン消費のもう一つの大きな要因は、エージェントが作業を進める中で追加していくコンテキストで、その多くはファイルの読み取りによるものです。
Cursorのエージェントは Read ツールを使ってファイルを読み取ります。このツールは従来、すべての行に行番号を付けていました。モデルは自力で行数を数えるのが苦手なうえ、ユーザーに特定の箇所を示す必要があるためです。
行番号1つに使われるトークンは3〜5程度にすぎませんが、エージェントが1回のセッションで数万行を読み取るとなると、そのすべてに番号を付けることで無視できない量のコンテキストが積み上がります。
そこで私たちは、10行ごとにだけ行番号を付けることでこのオーバーヘッドを削減しました。この頻度でもモデルがコードを適切に引用するには十分であり、この変更によって品質を落とすことなくキャッシュ読み取りトークンを1.6%削減できました。
サブエージェントを戦略的に使う
エージェントの実行が長くなるほど、サブエージェントに作業を委譲する機会も増えます。各サブエージェントは通常、親エージェントの会話全体を引き継がず、まっさらなコンテキストウィンドウから始まるため、トークン消費を抑えられます。サブエージェントが結果を報告した後も、親はサブエージェントの作業コンテキスト全体を抱え込むことなく処理を続けられます。
ただし、エージェントとサブエージェントの間のこうしたコンテキスト分離には調整コストが伴います。コンテキストを共有しないエージェント同士では、作業が重複したり、すでに不要になったタスクを進めてしまったりすることがあるからです。
不要な調整を増やさずに効率面の利点を得るため、私たちは2つの変更を加えました。1つ目は、コードベースの探索にサブエージェントを使うよう強く促していた指示を削除したことです。学習データの中でサブエージェントが一般的になり、研究者がポストトレーニングにも取り入れたことで、モデルはこのパターンを自然に身につけました。余分なプロンプトをなくしたことで、サブエージェントの使用量はよりバランスの取れたものになりました。
サブエージェントのモデル選択も引き締めました。Cursor は利用可能などのモデルでもサブエージェントを起動できるため、モデルごとの死角を補ったり、高価な計画用モデルと安価な実装用モデルを組み合わせたりできます。ツールの引数を更新し、ユーザーまたはハーネスから指示された場合にのみエージェントが別のモデルを選ぶようにしました。
ハーネス の効率改善を継続する
長時間にわたる実行でコンテキストがどのように蓄積されるかを今後も測定し、エージェントの品質を損なわずに ハーネス が重複した処理を削減できる箇所を検証していきます。長期的には、エージェントがこなせる作業量の伸びに対して、トークン使用量の増加ははるかに緩やかになると見込んでいます。これらの知見は Grok Bot にも活かしており、独自の ハーネス を最適化することで、ユーザーが最小のコストで最大の成果を得られるよう取り組んでいます。


