Verbesserte Token-Effizienz für längere Agent-Läufe


Mit zunehmender Reife der Agents und ihrer Fähigkeit, anspruchsvollere Aufgaben zu bewältigen, hat sich der Token-Verbrauch verlagert. Agents arbeiten inzwischen länger und nehmen mehr Kontext von einem Schritt in den nächsten mit – dadurch wird immer wichtiger, wie wir diesen Kontext zusammenstellen und verwalten.
Where agent inference spend goes
Production traffic · width = share of total spend · shade = billing type
- Output
- Uncached input
- Cached input
Hinweise: System- & Tool-Definitionen umfassen Zusammenfassungen aus der Komprimierung. Benutzertext umfasst manuell hinzugefügte Skills. Skills & Plugins umfasst Skill-Beschreibungen, MCP-Tool-Beschreibungen und Regeln, die in den statischen Kontext einfließen.
In den letzten Monaten haben wir auf diesen Wandel reagiert, indem wir die Effizienz von Cursors Agent Harness verbessert haben. Das Harness gibt uns die direkte Kontrolle darüber, wie jede Anfrage zusammengestellt wird, wie Kontext wiederverwendet wird und wann Arbeit auf mehrere Agents aufgeteilt wird. Änderungen auf all diesen Ebenen haben die Token-Kosten für Benutzer um 7 % gesenkt, ohne die Qualität der Agents zu beeinträchtigen.
Den System-Prompt kürzen
Jeder Agent-Turn enthält Kontext, den Cursor bereitstellt, bevor das Modell mit der Arbeit beginnt. Dazu gehören der System-Prompt und die Definitionen der Tools, die der Agent nutzen kann. Da dieser Kontext über die gesamte Unterhaltung hinweg mitgeführt wird, war er zu einer der größten Kostenquellen geworden, die wir vollständig selbst steuern.
Als die Modelle noch weniger leistungsfähig waren, mussten wir Anweisungen zur Tool-Nutzung, zur Aufgabenverwaltung und zu Abläufen bei Codeänderungen bis ins Detail ausformulieren. Außerdem mussten wir uns gegen seltsame Verhaltensweisen absichern, etwa extrem lange Hash-Dumps, Binärausgaben und Emojis.
Mit besseren Modellen wurde ein Großteil dieser Vorgaben überflüssig. Statt langer Listen mit „Tu dies NICHT“-, „Du musst“- oder „Wichtig“-Anweisungen konnten wir einfach definieren, wie sich ein Tool verhält, und die Modelle hielten sich in der Regel daran. Das galt über Modellfamilien hinweg und erlaubte es uns, rund 66 % unseres System-Prompts zu streichen.
Mit der Zeit kommen weiterhin Anweisungen hinzu oder fallen weg, wenn neue Modelle andere Vorgaben brauchen – und das fließt wiederum in das Training künftiger Modelle ein. A/B-Tests mit einer großen Benutzerbasis sind entscheidend, um das Harness wirksam für echten Traffic zu optimieren. Evals sind zwar ein schneller und nützlicher Näherungswert, stehen aber oft für „schwere“ Probleme und spiegeln die tatsächliche Verteilung von Benutzeranfragen nicht richtig wider.
Tools nur bei Bedarf laden
Der System-Prompt ist nur ein Teil des Kontexts, den Cursor bei jedem Durchlauf bereitstellt. Ein weiterer sind die Tool-Definitionen, die im Laufe des Jahres stark gewachsen sind, da wir den Cursor-Agent um immer leistungsfähigere Funktionen erweitert haben – darunter die Überwachung von Hintergrund-Shells, Cloud-Subagents und einen zuverlässigeren Zugriff auf Web-Inhalte. Die meisten dieser Tools sind wichtig, doch jedes einzelne wird in weniger als 20 % der Unterhaltungen tatsächlich gebraucht.
Daraus ergab sich die Möglichkeit, die Effizienz zu steigern: Die Tools bleiben verfügbar, ohne dass ihre vollständigen Definitionen in jeder Anfrage mitgeschickt werden. Ein ähnliches Problem hatten wir bereits Anfang des Jahres gelöst, als wir MCP-Tools in den dynamischen Kontext verlagert und nur noch bei Bedarf geladen haben. Dadurch sank die Gesamtzahl der Token über alle Sessions hinweg, in denen ein MCP-Tool aufgerufen wurde, um 46,9 %.
Dieselbe Technik haben wir nun auf unsere eigenen integrierten Tools angewendet.
Um zu entscheiden, welche Tools im statischen Kontext bleiben, haben wir mehrere Konfigurationen per A/B-Test geprüft – ausgehend davon, wie häufig ein Tool genutzt wurde und ob Modelle es von Anfang an sehen mussten. Dabei haben wir Token-Nutzung, Kosten, Latenz, Fehlermeldungen bei Tool-Aufrufen und die gesamte Agent-Nutzung im Blick behalten, um sicherzustellen, dass die Einsparungen nicht zulasten der Qualität gehen.
Most commonly invoked tools
Share of agent conversations invoking each tool at least once
Am Ende haben wir die häufig genutzten Tools zum Lesen, Durchsuchen, Bearbeiten und Verwenden der Shell im statischen Kontext belassen. Beibehalten haben wir außerdem ask_question, für das manche Modelle dazu neigten, Aufrufe zu halluzinieren, sowie Tools, die für bestimmte Produktabläufe entscheidend sind, etwa create_plan im Plan-Modus. Alle übrigen Tools werden nun erst geladen, wenn der Agent sie benötigt.
Offloading built-in tools cut static-context description tokens by 60%
- Kept in static context
- Offloaded to dynamic context
Bessere Cache-Wiederverwendung
Nachdem wir den Umfang des statischen Kontexts pro Anfrage reduziert hatten, haben wir verbessert, wie effektiv sich wiederholender Kontext über Turns hinweg zwischengespeichert werden kann.
Jeder Agent-Turn sendet erneut eine lange Anfrage, die Tools, Systemanweisungen, das Setup und die bisherige Unterhaltung enthält. Ein Großteil des Anfangs bleibt von einem Turn zum nächsten gleich, während die Unterhaltung am Ende immer weiter wächst.
Prompt-Caching ermöglicht es dem Modellanbieter, diesen unveränderten Präfix wiederzuverwenden. Wie weit sich das Caching konfigurieren lässt, hängt allerdings vom jeweiligen Anbieter ab. Vor GPT-5.6 wurde die Cache-Grenze automatisch anhand der neuesten Anfrage bestimmt. Obwohl sich Tools und Systemanweisungen nur selten änderten, waren sie für sich genommen nicht sauber als wiederverwendbar gekennzeichnet.
Seit GPT-5.6 können Clients über die OpenAI-API neben dem standardmäßigen impliziten Caching auch explizite Cache-Breakpoints setzen. Wir platzieren diese Breakpoints nun nach den stabilen Schichten der Anfrage und vor der wachsenden Unterhaltung, sodass spätere Turns einen größeren Teil des unveränderten Präfixes wiederverwenden können.
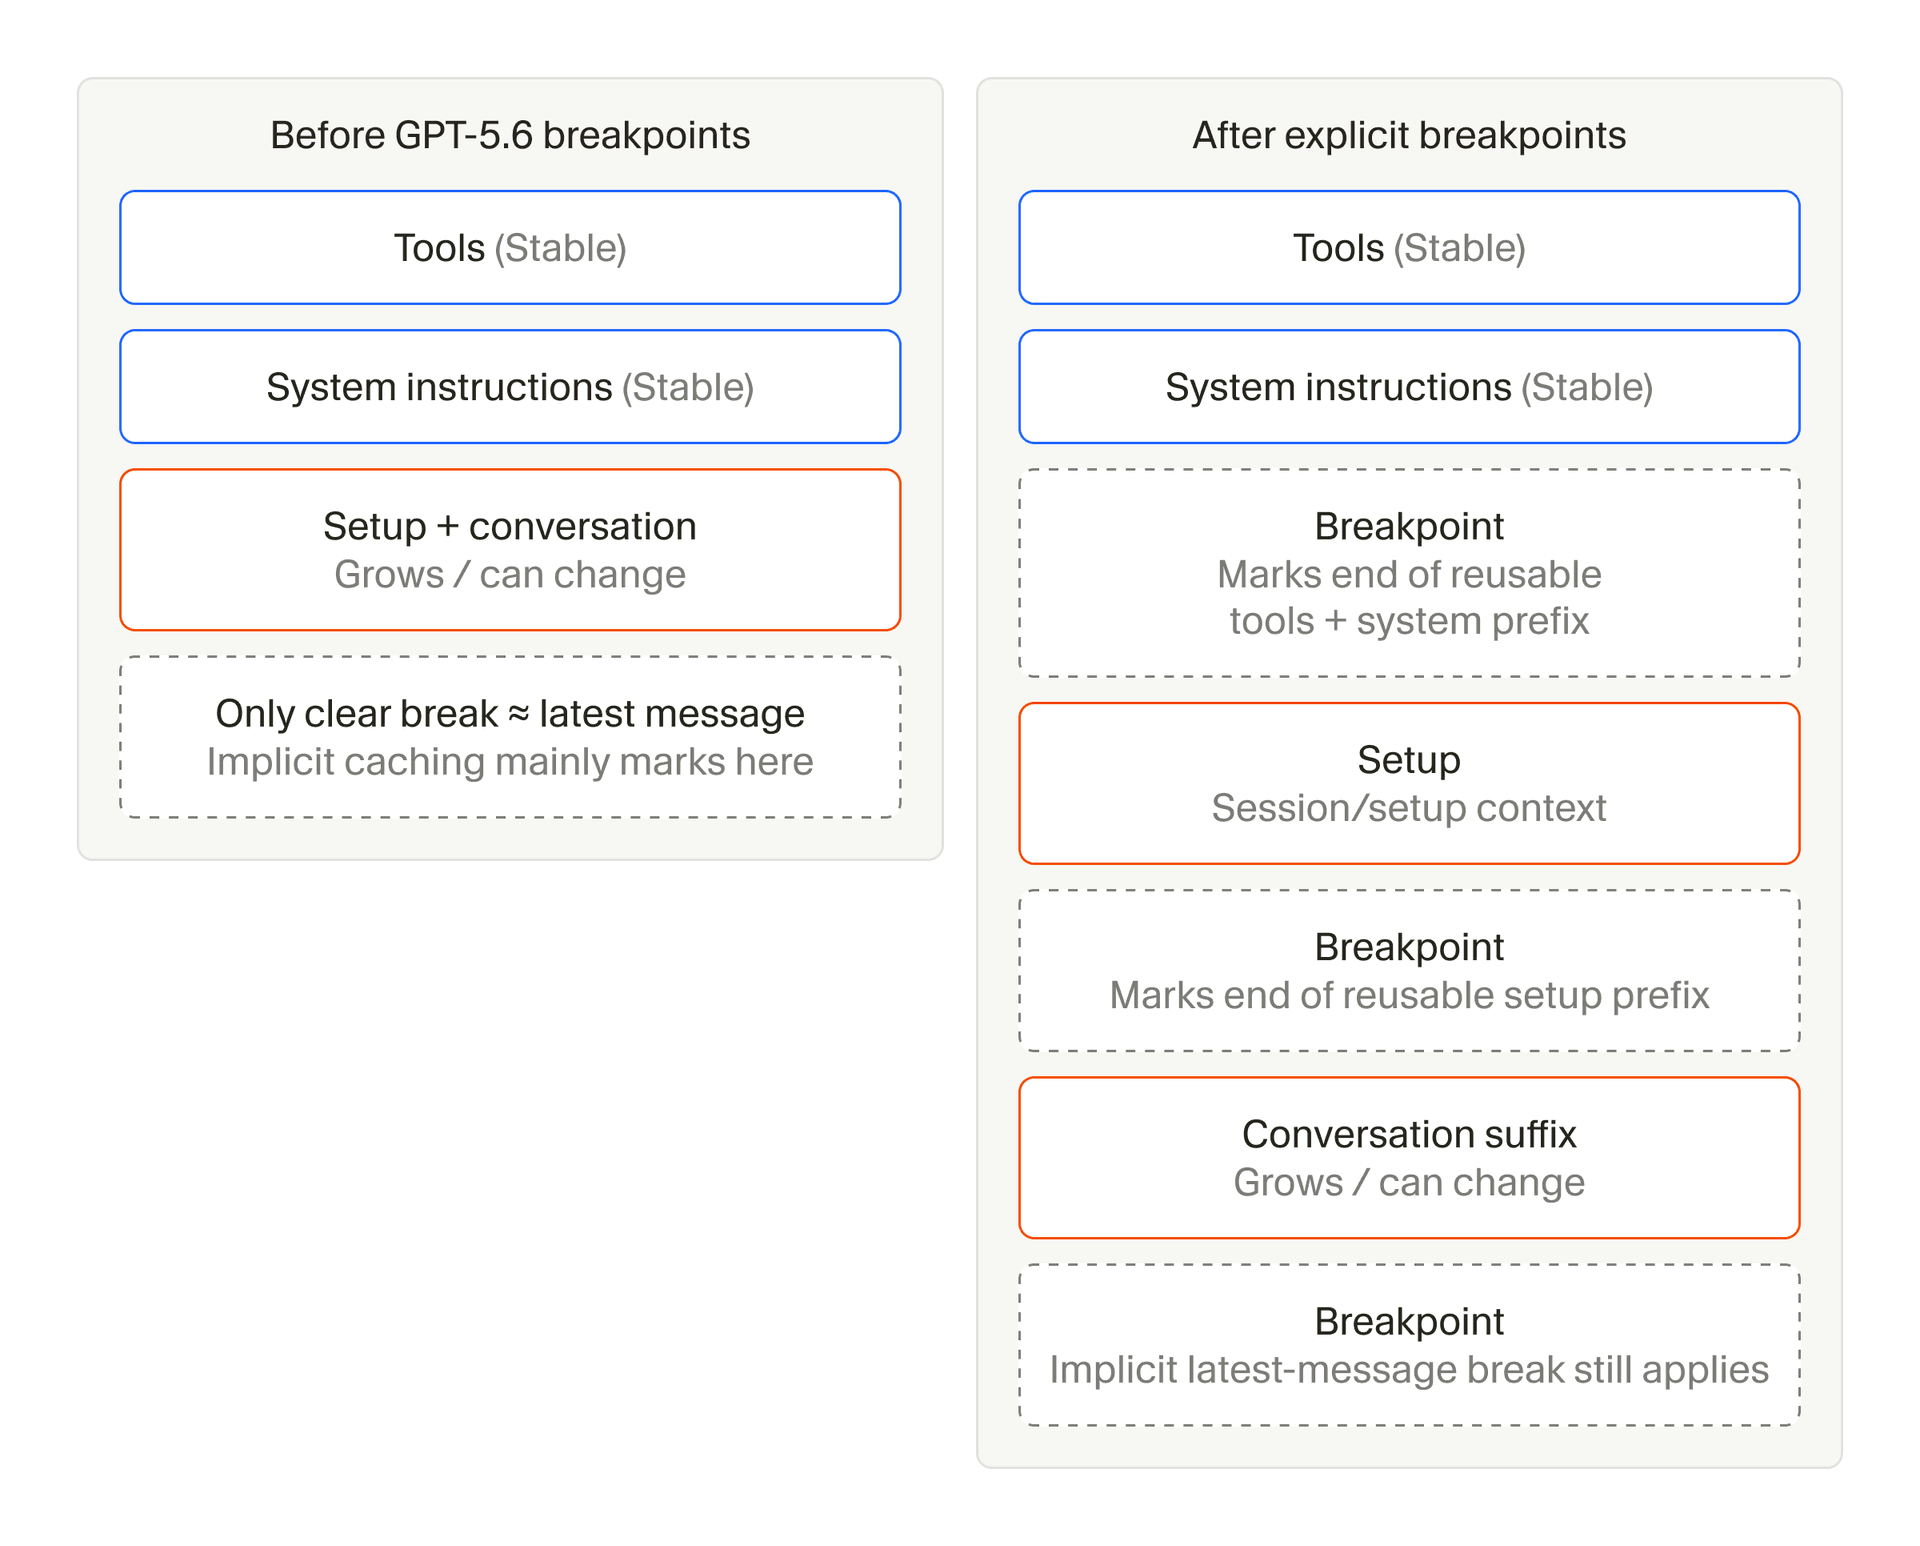
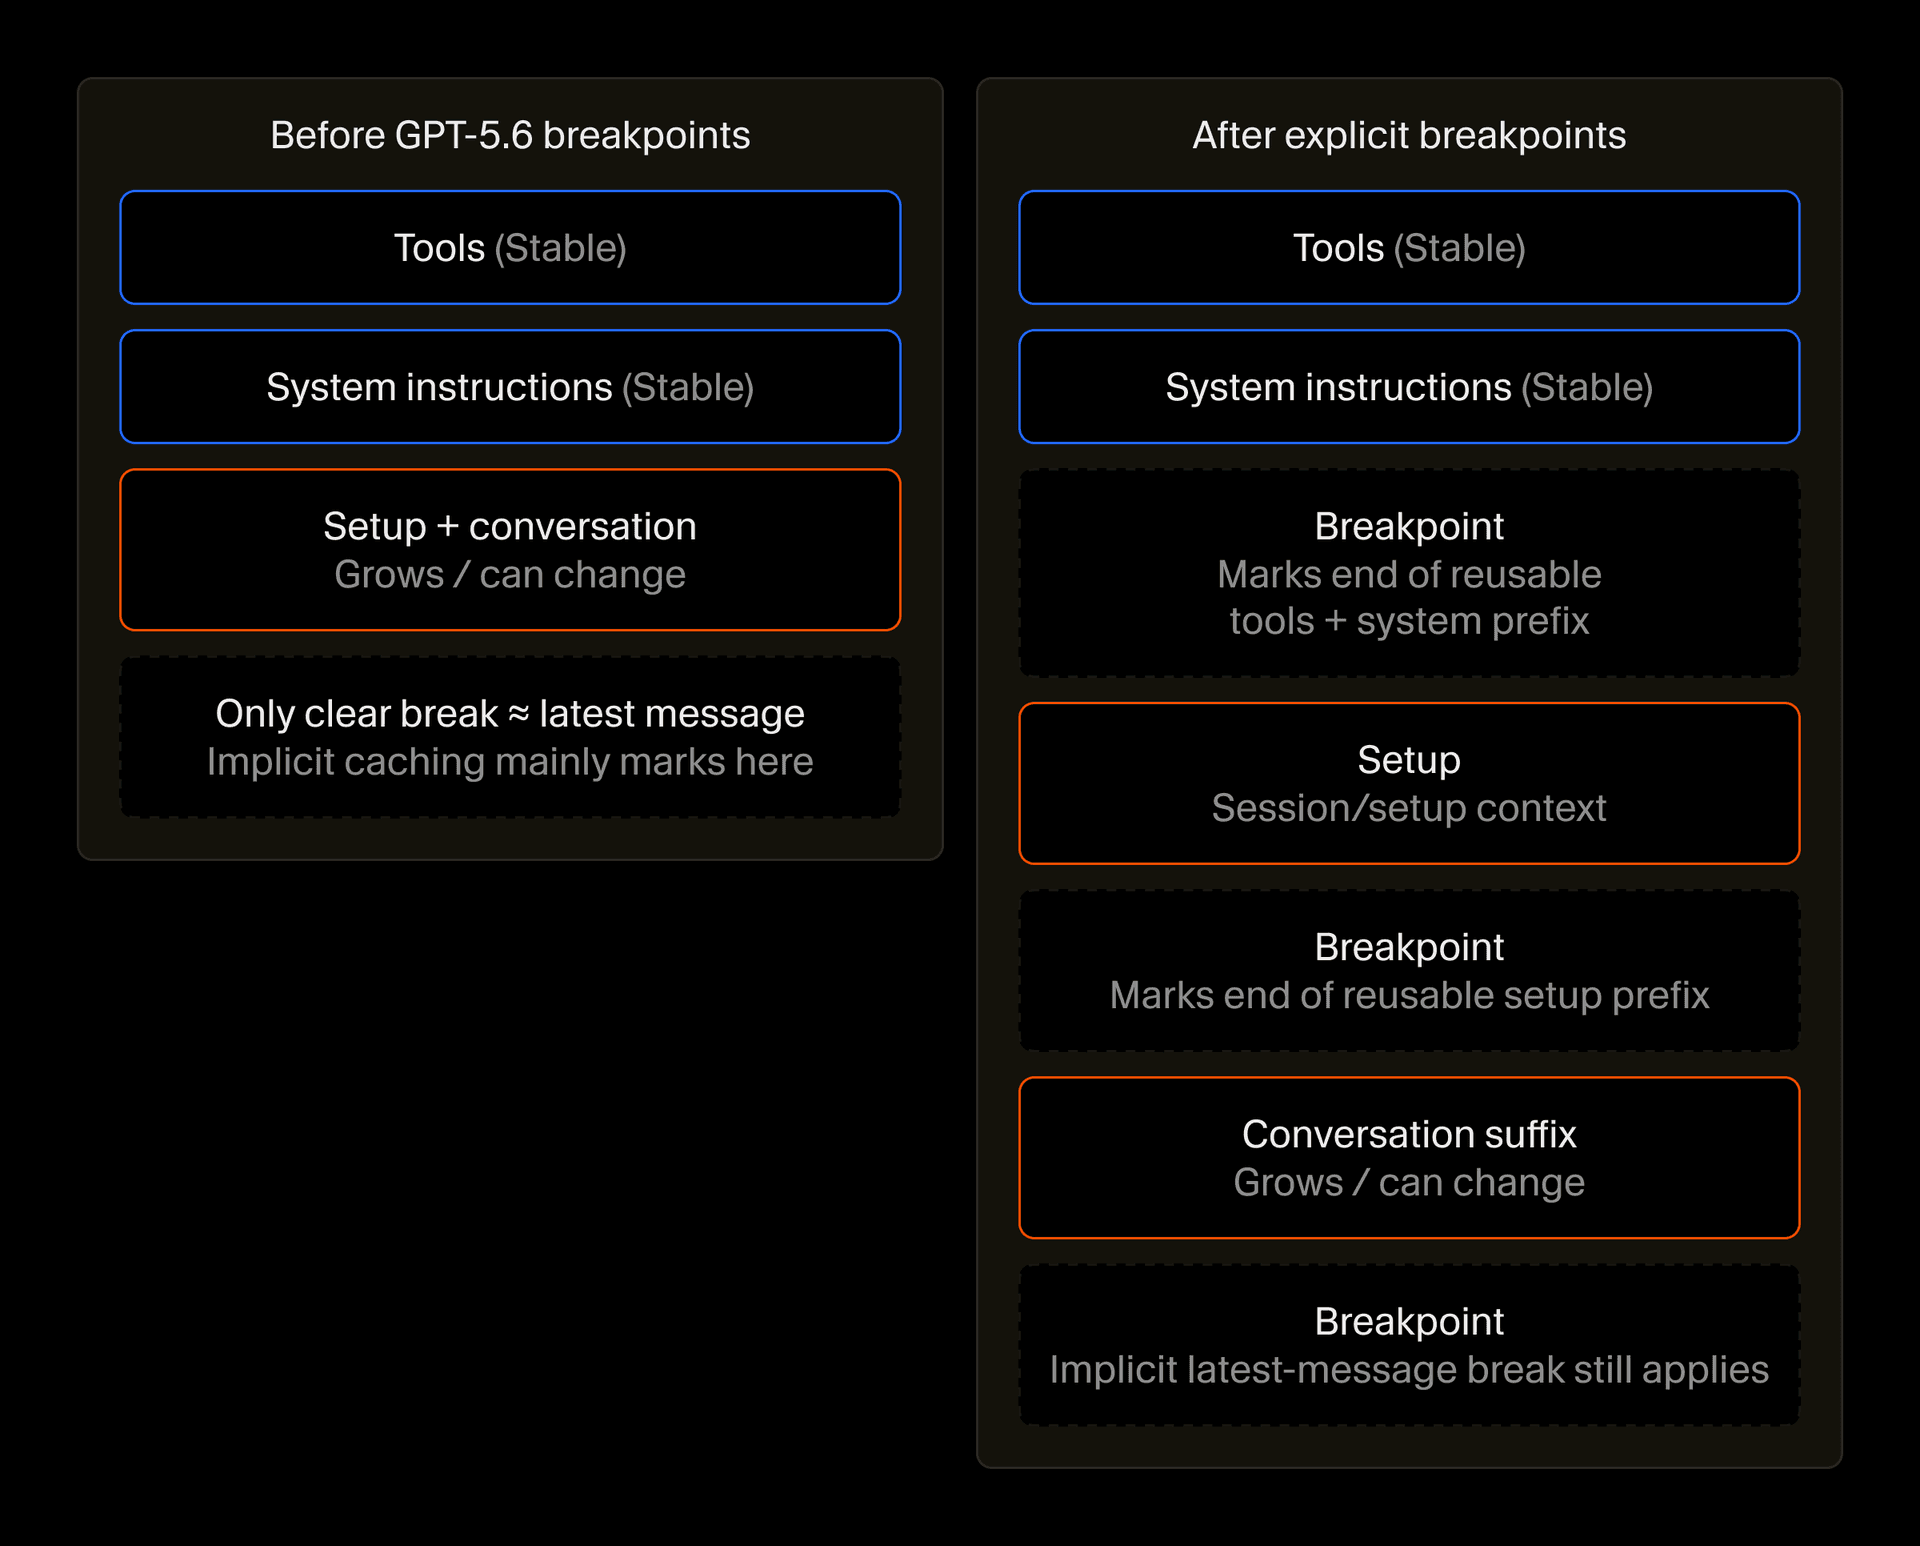
Breakpoints helfen nur, wenn das Präfix selbst stabil bleibt – deshalb haben wir auch aufgeräumt, was am Anfang jeder Anfrage steht. Dazu haben wir Tools und Systemanweisungen für Inhalte reserviert, die sich selten ändern, und stärker variierendes Setup hinter die Cache-Grenzen in unsere „Phantom-User-Message“ verschoben. Darin steckt benutzer- und anfragespezifischer Kontext wie Skills, Subagents und Umgebungsinformationen.
Diese Änderungen haben die Rate kalter Cache Misses um 20 % gesenkt.
Datei-Lesevorgänge komprimieren
Eine weitere große Quelle für Token-Verbrauch ist der Kontext, den ein Agent während der Arbeit hinzufügt – ein Großteil davon stammt aus dem Lesen von Dateien.
Der Agent von Cursor liest Dateien über ein Read-Tool, das bisher jede Zeile nummeriert hat, weil Modelle selbst nicht gut Zeilen zählen können und für den Benutzer bestimmte Abschnitte zitieren müssen.
Eine einzelne Zeilennummer verbraucht nur etwa drei bis fünf Token, aber wenn ein Agent während einer Sitzung Zehntausende Zeilen liest, summiert sich die Nummerierung jeder einzelnen Zeile zu einer erheblichen Menge an Kontext.
Wir haben diesen Overhead reduziert, indem wir Zeilennummern nur noch auf jeder zehnten Zeile einfügen. Das ist nach wie vor häufig genug, damit Modelle Code korrekt zitieren können, und die Änderung senkte die Cache-Read-Token um 1,6 % – ohne Einbußen bei der Qualität.
Subagents strategisch einsetzen
Längere Agent-Läufe schaffen mehr Gelegenheiten, Arbeit an Subagents zu delegieren. Das kann den Token-Verbrauch senken, da jeder Subagent in der Regel mit einem frischen Kontextfenster startet, statt die vollständige Unterhaltung des übergeordneten Agents mitzuführen. Sobald er seine Ergebnisse zurückmeldet, kann der übergeordnete Agent weiterarbeiten, ohne den gesamten Arbeitskontext des Subagents zu übernehmen.
Diese Art der Kontextisolation zwischen Agents und Subagents bringt allerdings einen Koordinationsaufwand mit sich, denn Agents ohne gemeinsamen Kontext können Arbeit doppelt erledigen oder Aufgaben verfolgen, die längst nicht mehr nötig sind.
Wir haben zwei Änderungen vorgenommen, um die Effizienzvorteile zu nutzen, ohne unnötige Koordination zu erzeugen. Zunächst haben wir Anweisungen entfernt, die Agents nachdrücklich dazu angehalten haben, Subagents für die Exploration der Codebasis einzusetzen. Da Subagents in den Trainingsdaten häufiger vorkamen und Forscher sie ins Post-Training einbezogen haben, haben die Modelle dieses Muster von sich aus gelernt. Ohne das zusätzliche Prompting fiel die Nutzung von Subagents ausgewogener aus.
Außerdem haben wir präzisiert, wie Subagents Modelle auswählen. Cursor kann Subagents mit jedem unserer verfügbaren Modelle starten. So lassen sich blinde Flecken einzelner Modelle ausgleichen oder ein teures Modell für die Planung mit einem günstigeren für die Implementierung kombinieren. Wir haben die Tool-Argumente so angepasst, dass Agents nur dann ein anderes Modell wählen, wenn der Benutzer oder das Harness es vorgibt.
Weitere Verbesserungen der Harness-Effizienz
Wir werden weiterhin messen, wie sich Kontext über längere Agent-Läufe hinweg ansammelt, und testen, an welchen Stellen die Harness wiederholte Verarbeitung reduzieren kann, ohne die Qualität des Agents zu beeinträchtigen. Langfristig erwarten wir, dass die Token-Nutzung dadurch deutlich langsamer wächst als der Arbeitsumfang, den Agents bewältigen können. Diese Erkenntnisse haben wir auch auf Grok Bot übertragen, wo wir dessen eigene Harness so optimieren, dass Benutzer mit möglichst geringen Kosten ein möglichst großes Arbeitspensum erledigen können.


